Operational Health Matrix (OHM)
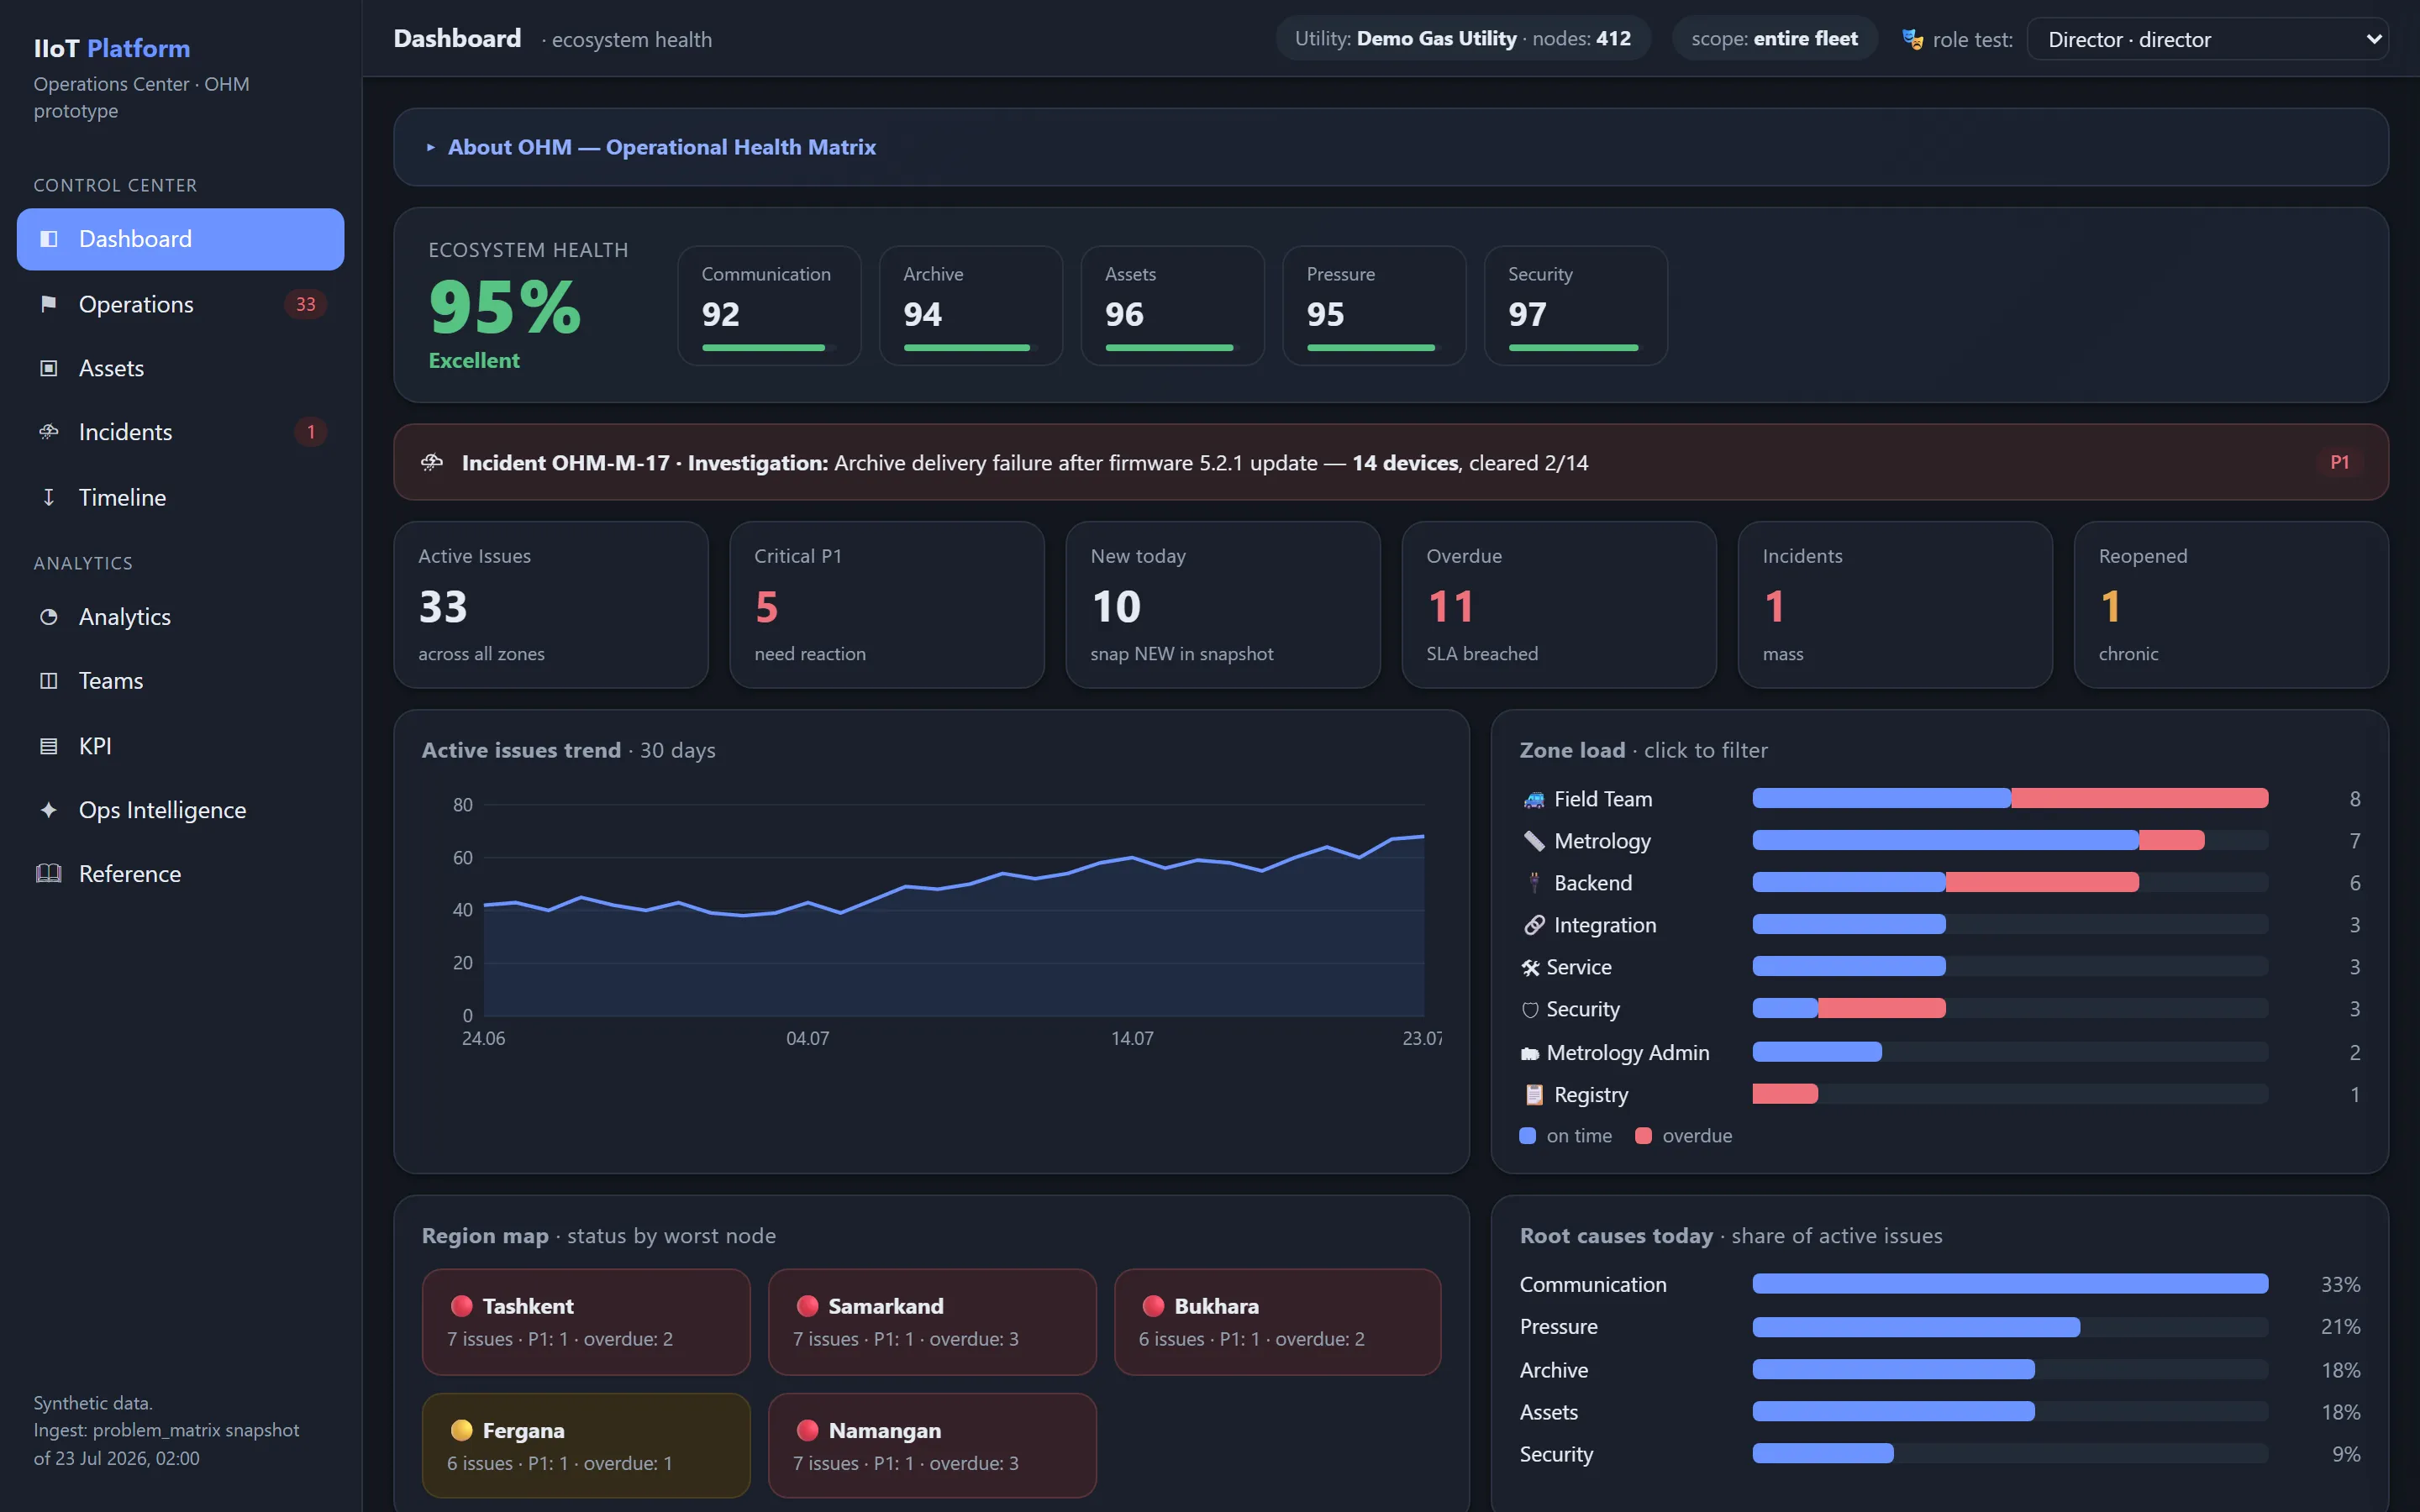
Operational Health Matrix je velitelské centrum provozu subsystému Data Platform — převádí telemetrii a zjištění analytiky na řízený pracovní cyklus, od automatické detekce problému až po odstranění potvrzené daty.
Operational Health Matrix (OHM) je centrální provozní modul subsystému Data Platform. Převádí tok telemetrie, výsledky analytiky a provozní události na řízený pracovní cyklus: od automatické detekce problému až po odstranění potvrzené daty.
OHM spojuje v jediném systému:
- detekci technických, metrologických a integračních problémů;
- korelaci symptomů a určení pravděpodobné kořenové příčiny (Root Cause);
- vytváření a vedení objektů
Operational Issue; - přidělování odpovědných týmů a řešitelů;
- řízení termínů, priorit a SLA;
- vedení úkolů (Tasks), komentářů, důkazů (Evidence) a historie akcí;
- automatické ověření výsledku podle nových dat;
- řízení hromadných incidentů (Massive Incident);
- hodnocení stavu zařízení a celé flotily;
- výpočet provozních a týmových KPI;
- shromažďování potvrzených řešení ve znalostní bázi (Knowledge Base);
- AI-podporu analýzy, aniž by umělá inteligence získala právo činit kritická rozhodnutí.
flowchart TD
  A["Telemetrie"] --> B["Detektory"]
  B --> C["Evidence"]
  C --> D["Korelace a Root Cause"]
  D --> E["Operational Issue"]
  E --> F["Přidělení a realizace"]
  F --> G["Ověření podle dat"]
  G --> H["Uzavření a Knowledge Base"]
  H --> I["KPI a neustálé zlepšování"]
Účel modulu
Tradiční telemetrické systémy dobře odpovídají na otázku:
Co se stalo se zařízením nebo s daty?
Pro řízení rozsáhlé flotily to však nestačí. Po detekci události musí organizace určit:
- zda signál představuje skutečný problém;
- zda se týká jediného zařízení, nebo jde o celosystémový incident;
- které další symptomy souvisejí s toutéž kořenovou příčinou;
- kdo odpovídá za jeho odstranění;
- do kdy musí být práce dokončena;
- jaké kroky již byly podniknuty;
- zda bylo odstranění potvrzeno objektivními daty;
- zda se problém opakuje;
- jak účinně funguje provozní proces.
OHM uzavírá celý tento cyklus.
Hlavním výstupem modulu není upozornění ani řádek reportu, ale řízený provozní objekt, který má:
- identifikátor;
- typ problému;
- dotčená aktiva (Assets);
- důkazy;
- závažnost (Severity);
- úroveň jistoty (confidence);
- pravděpodobnou a potvrzenou kořenovou příčinu;
- vlastníka;
- řešitele;
- termín;
- úkoly;
- historii;
- stav ověření;
- výsledek odstranění;
- vazbu na znalostní bázi;
- vliv na KPI.
Klíčová výhoda
Platforma se neomezuje na zaznamenávání odchylek. Platforma provází problém až k potvrzenému výsledku.
flowchart TD
  subgraph OPS["Data Platform a OHM"]
    direction TB
    O1["Zjistila problém"] --> O2["Ověřila důkazy"]
    O2 --> O3["Sloučila související signály"]
    O3 --> O4["Určila prioritu"]
    O4 --> O5["Přidělila zónu odpovědnosti"]
    O5 --> O6["Hlídá termín"]
    O6 --> O7["Ověřila výsledek podle dat"]
    O7 --> O8["Uložila potvrzené řešení"]
  end
  subgraph MON["Monitorovací systém"]
    direction TB
    M1["Zjistil problém"] --> M2["Zde práce systému končí"]
  end
Díky tomu OHM převádí provoz z reaktivního režimu do řízeného modelu, v němž má každá významná odchylka vlastníka, termín, důkazy a měřitelný výsledek.
Základní principy
Issues místo alarmů
Jednotlivý alarm ne vždy znamená provozní problém.
Jediná fyzická porucha může vyvolat desítky až stovky událostí:
- chybí komunikační relace;
- chybí archiv;
- zastaralá data;
- neznámý stav baterie;
- chybí aktuální tlak;
- chyba doručení.
OHM nevytváří samostatnou pracovní položku pro každý symptom. Systém signály koreluje a vytvoří jediný Operational Issue, pokud mají společnou příčinu.
Provoz řízený důkazy (Evidence)
Každý automatický závěr musí být vysvětlitelný.
Issue obsahuje:
- zdrojové hodnoty;
- časové značky;
- identifikátor detektoru;
- verzi algoritmu;
- použité prahové hodnoty;
- odkaz na příslušný specializovaný report;
- historii opakování;
- související signály;
- výsledek korelace.
Uživatelé mohou vždy vysledovat cestu od surové telemetrie až k vytvořenému Issue.
Nejprve kořenová příčina (Root Cause)
OHM rozlišuje:
- symptom — pozorovanou odchylku;
- příčinu — technický nebo organizační faktor, který odchylku vyvolal;
- kořenovou příčinu — primární faktor, jehož odstranění zabrání opakování celé skupiny symptomů.
Příklad:
flowchart LR
  S1["Symptom 1: chybí hodinový archiv"] --> RC["Pravděpodobná kořenová příčina: degradace zdroje napájení"]
  S2["Symptom 2: poslední relace proběhla před 9 dny"] --> RC
  S3["Symptom 3: napětí baterie klesalo"] --> RC
  S4["Symptom 4: délka relací rostla"] --> RC
Uzavření potvrzené daty
Řešitel oznámí, že práce je hotová, ale konečný status resolved se nastaví až po ověření výsledku.
flowchart TD
  V1["Práce dokončena"] --> V2["awaiting_verification"]
  V2 --> V3["Nová data potvrzují normalizaci"]
  V3 --> V4["resolved"]
U problémů, které nelze ověřit telemetrií, se používá řízené ruční ověření s povinným komentářem a podpůrnými důkazy.
Asset ve středu modelu
Všechny události, Issues, pracovní položky i metriky se vážou k aktivům (Assets):
- měřicí uzly;
- korektory;
- měřidla;
- senzory;
- modemy;
- brány;
- SIM karty;
- serverové komponenty;
- integrační kanály;
- verze softwaru.
Karta aktiva zobrazuje aktuální zdraví (Asset Health), historii degradace, aktivní Issues, provedené práce a opakování problémů.
Odpovědnost nese člověk, AI pomáhá
AI pomáhá:
- shrnovat Evidence;
- sestavovat pořadí hypotéz;
- vyhledávat podobné případy;
- navrhovat známá řešení;
- odhalovat nové shluky;
- předpovídat riziko poruchy.
AI nemůže samostatně:
- měnit prioritu;
- přidělovat odpovědnost;
- uzavírat Issue;
- potvrzovat Root Cause jako prokázaný fakt;
- měnit SLA;
- provádět kritické zásahy na zařízení.
Reprodukovatelnost daná návrhem
Všechny významné výpočty jsou reprodukovatelné. Ke každému výsledku platforma ukládá:
- verzi detektoru;
- verzi kánonu (Canon);
- verzi korelačního modelu;
- použitou datovou sadu;
- čas výpočtu;
- prahové hodnoty;
- konfiguraci;
- zdroj změny.
Místo OHM v architektuře subsystému Data Platform
OHM je umístěn mezi analytickou vrstvou a řízením provozu.
flowchart TD
  PHY["Fyzická aktiva"] --> DATA["Datová a integrační vrstva IIoT"]
  DATA -->|"Normalizovaná data"| ANL["Analytika a detekce"]
  ANL -->|"Evidence a zjištění"| OHM["Operational Health Matrix"]
  OHM -->|"API, události, integrace"| ENT["Podnikové systémy"]
Obsah vrstev:
| Vrstva | Komponenty |
|---|---|
| Fyzická aktiva | měřidla, korektory, senzory, brány, armatury |
| Datová a integrační vrstva IIoT | telemetrie, archivy, registr, pasporty, události |
| Analytika a detekce | kanonické detektory, hloubkové reporty, AI, korelace |
| Operational Health Matrix | Issues, Tasks, SLA, ověřování, KPI, znalostní báze |
| Podnikové systémy | ERP, EAM, CMMS, Service Desk, BI, notifikace |
Zdroje dat
OHM využívá:
- aktuální telemetrii;
- hodinové, denní a událostní archivy;
- logy komunikačních relací;
- údaje z pasportů a registru;
- statusy zařízení;
- data o baterii;
- tlak, teplotu, průtok a objem;
- události manipulace;
- verze firmwaru;
- parametry komunikace;
- výsledky specializovaných reportů;
- ruční pozorování uživatelů;
- události z externích systémů.
Poskytovatelé Evidence
Zdrojem důkazů může být kterýkoli analytický modul platformy.
Příklady:
| Poskytovatel Evidence | Co předává do OHM |
|---|---|
| Matice problémů flotily | kanonické problémy a denní statusy |
| Analytika hodinového archivu | úplnost, mezery, koncová mezera, věrohodnost dat |
| Analýza relací | délka, četnost, anomálie komunikace |
| Analýza tlaku | hodnoty mimo rozsah, skoky, zaseknuté hodnoty |
| Analýza teploty | anomálie, rozpory, fyzikální věrohodnost |
| Podezření na manipulaci | forenzní signály a confidence |
| Analýza baterie | trend, prahy, prognóza zbytkové životnosti |
| Kontrola pasportu | chybějící a rozporné parametry |
| Kontrola registru | duplicity, ghost objekty, nekonzistence identifikátorů |
| Firmware Analytics | shluky problémů podle verze softwaru |
Prozkoumejte modul
Dashboardy podle rolí, fronty a obrazovky, ve kterých týmy pracují každý den.
Klíčové entity — Asset, Detector, Evidence, Issue, Task — a vazby mezi nimi.
Objekt Operational Issue a jeho statusy od detekce až po uzavření potvrzené daty.
Jak detektory převádějí telemetrii na verzované kanonické definice problémů.
Neměnné důkazy, korelace symptomů a určení pravděpodobné kořenové příčiny.
Jak závažnost a dopad určují prioritu, časovače SLA a cesty eskalace.
Úkoly, přidělení, komentáře a pracovní fronta, která posouvá řešení vpřed.
Vypočítané ukazatele zdraví pro aktiva, lokality, regiony a celý ekosystém.
Metriky, které měří provozní proces i týmy, jež jej zajišťují.
Potvrzená řešení, která se shromažďují a znovu využívají u opakujících se problémů.
AI-podpora při shrnování, řazení a predikci bez práva rozhodovat.
Sdružování souvisejících Issues do jediného objektu rozsáhlého incidentu.
API, externí systémy, řízení přístupu a požadavky auditu.
Související témata
Byla tato stránka užitečná?
Děkujeme za vaši zpětnou vazbu!