Operational Health Matrix (OHM)
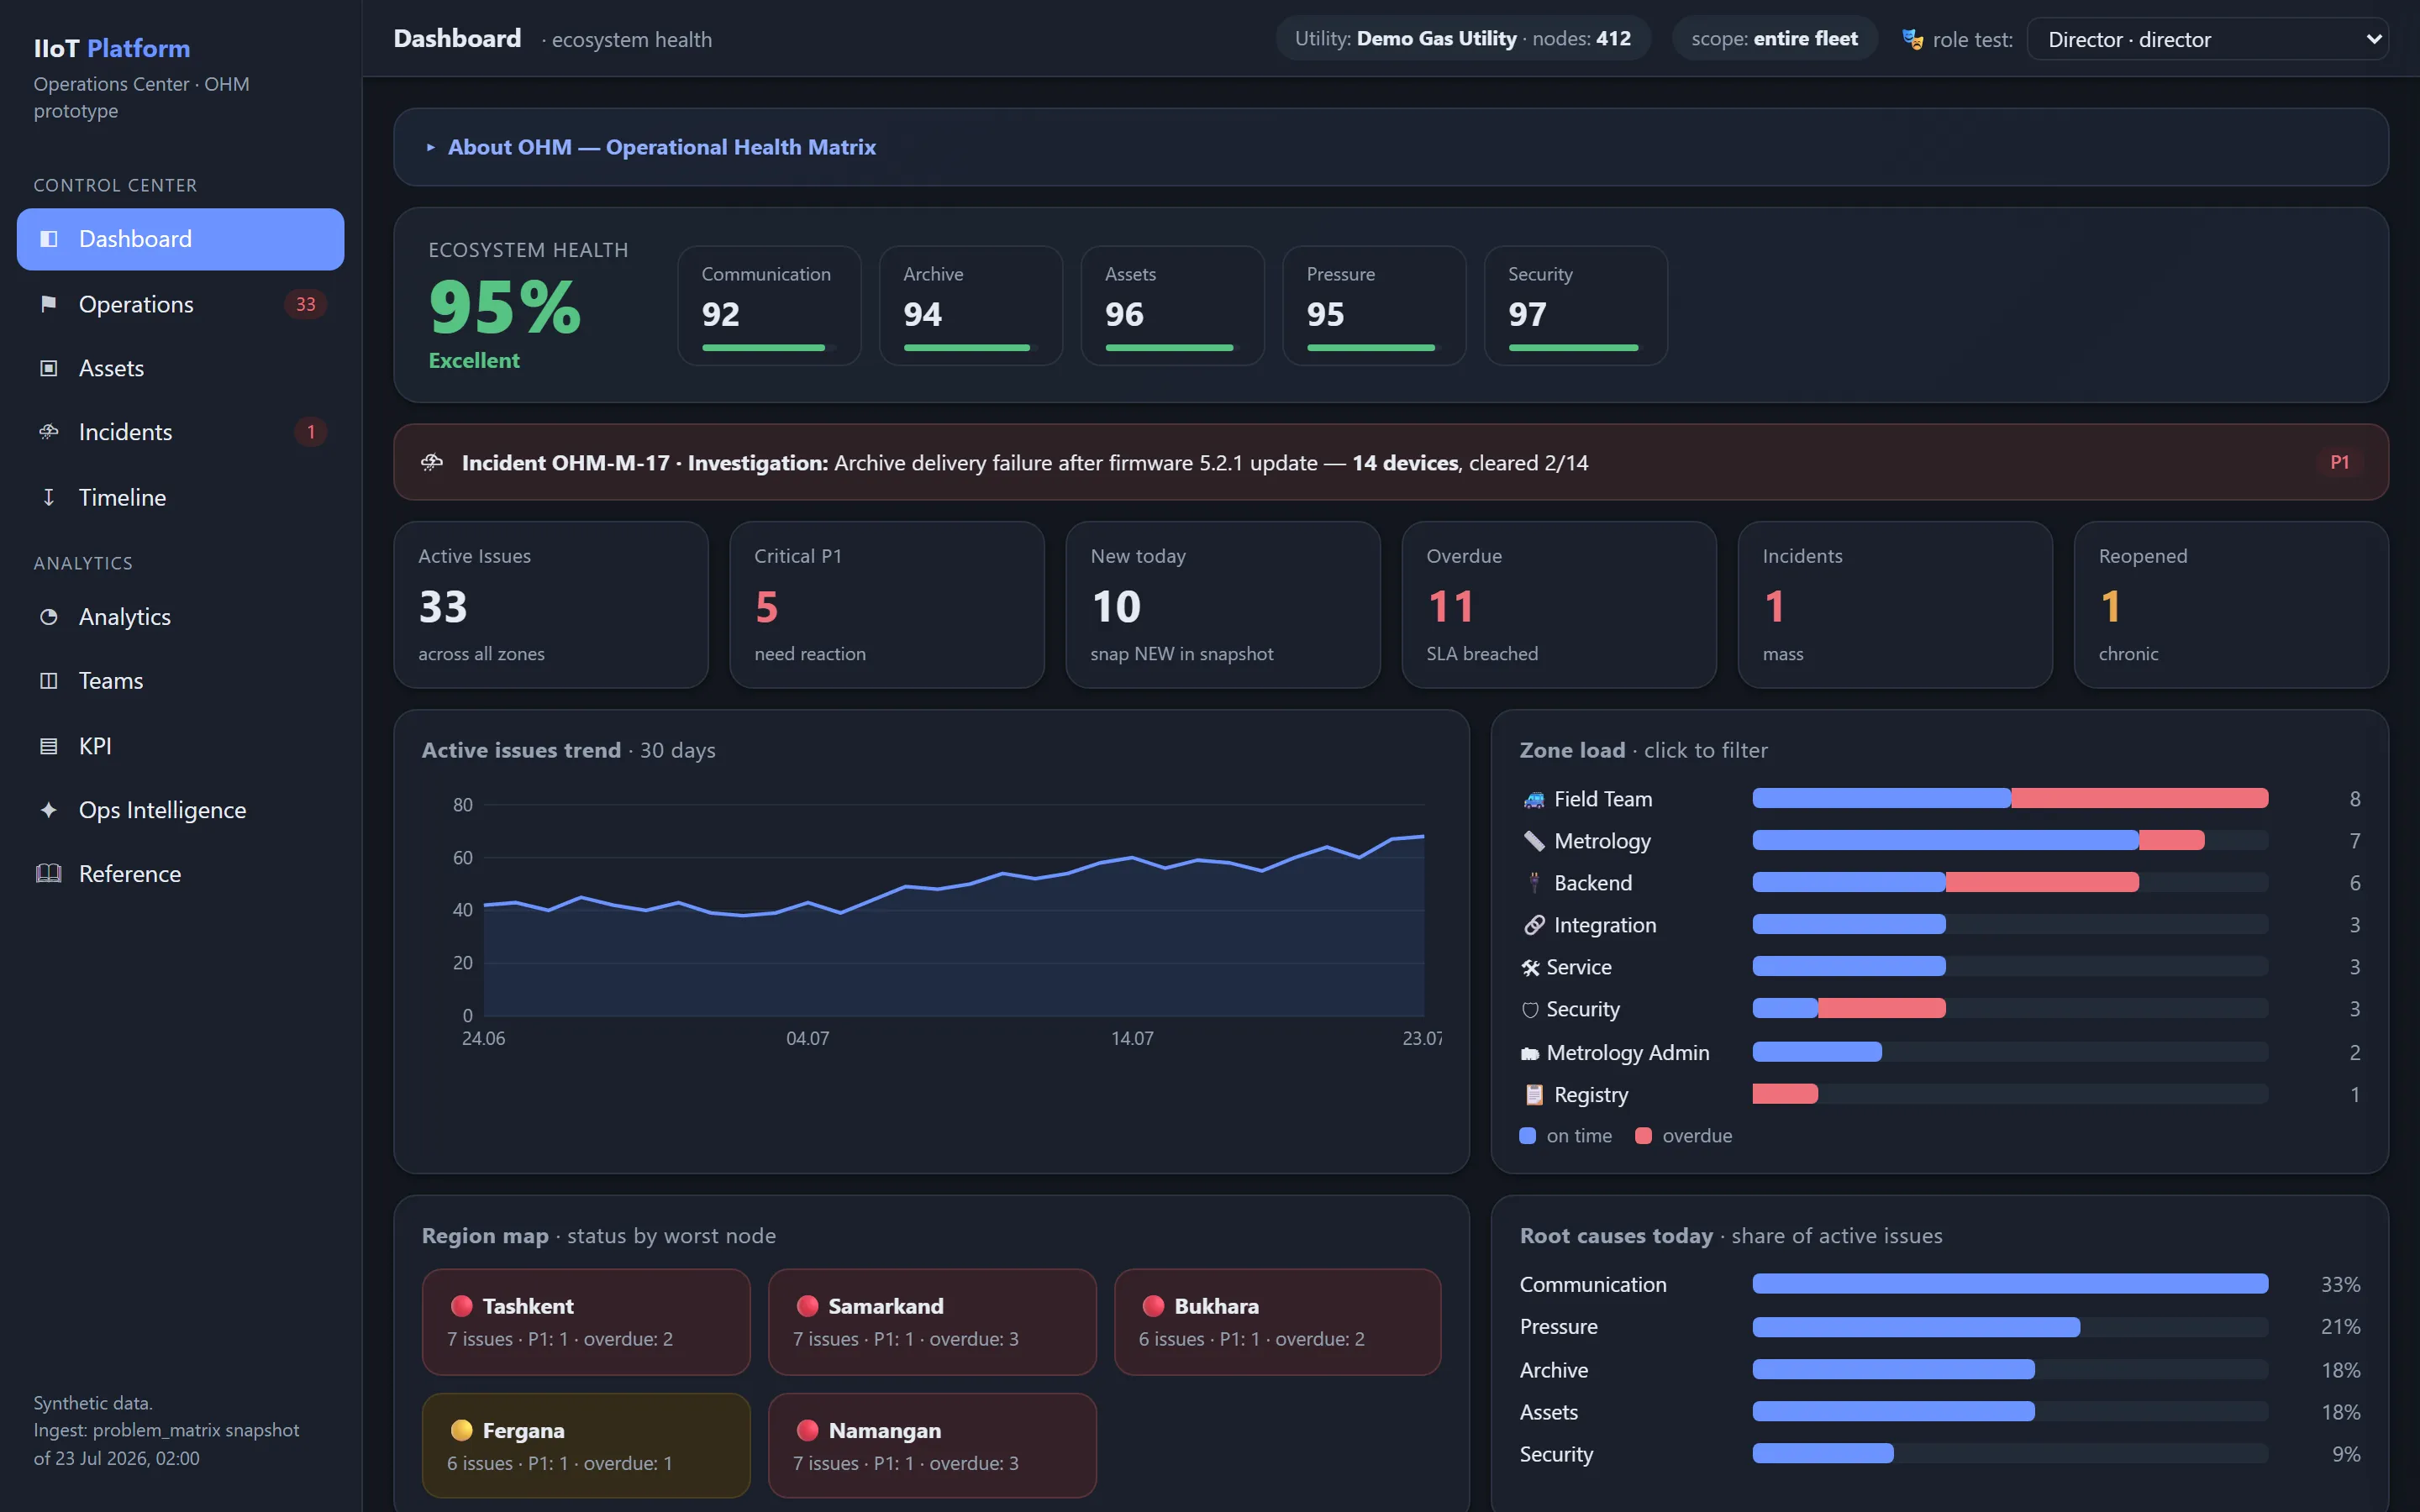
Operational Health Matrix este centrul de comandă al activității operaționale din Data Platform – transformă constatările telemetriei și ale analizelor într-un ciclu de lucru gestionat, de la detectarea automată a problemelor până la rezolvarea confirmată de date.
Operational Health Matrix (OHM) este subsistemul operațional central din Data Platform. Transformă fluxul de telemetrie, rezultatele analizelor și evenimentele operaționale într-un ciclu de lucru gestionat: de la detectarea automată a problemelor până la rezolvarea confirmată de date.
OHM reunește într-un singur sistem:
- detectarea problemelor tehnice, metrologice și de integrare;
- corelarea simptomelor și identificarea cauzei fundamentale probabile;
- crearea și gestionarea entităților
Operational Issue; - atribuirea echipelor responsabile și a executanților;
- gestionarea termenelor, a priorităților și a acordurilor privind nivelul serviciilor (SLA);
- urmărirea sarcinilor, a comentariilor, a dovezilor și a istoricului acțiunilor;
- verificarea automată a rezultatelor pe baza datelor noi;
- gestionarea incidentelor masive;
- evaluarea stării echipamentelor și a parcului de dispozitive;
- calculul indicatorilor-cheie de performanță (KPI) operaționali și ai echipelor;
- acumularea soluțiilor confirmate în baza de cunoștințe;
- analiza asistată de IA, fără a delega inteligenței artificiale dreptul de a lua deciziile critice.
flowchart TD
  A["Telemetrie"] --> B["Detectors"]
  B --> C["Evidence"]
  C --> D["Corelare și Root Cause"]
  D --> E["Operational Issue"]
  E --> F["Atribuire și execuție"]
  F --> G["Verificare pe baza datelor"]
  G --> H["Închidere și Knowledge Base"]
  H --> I["KPI și îmbunătățire continuă"]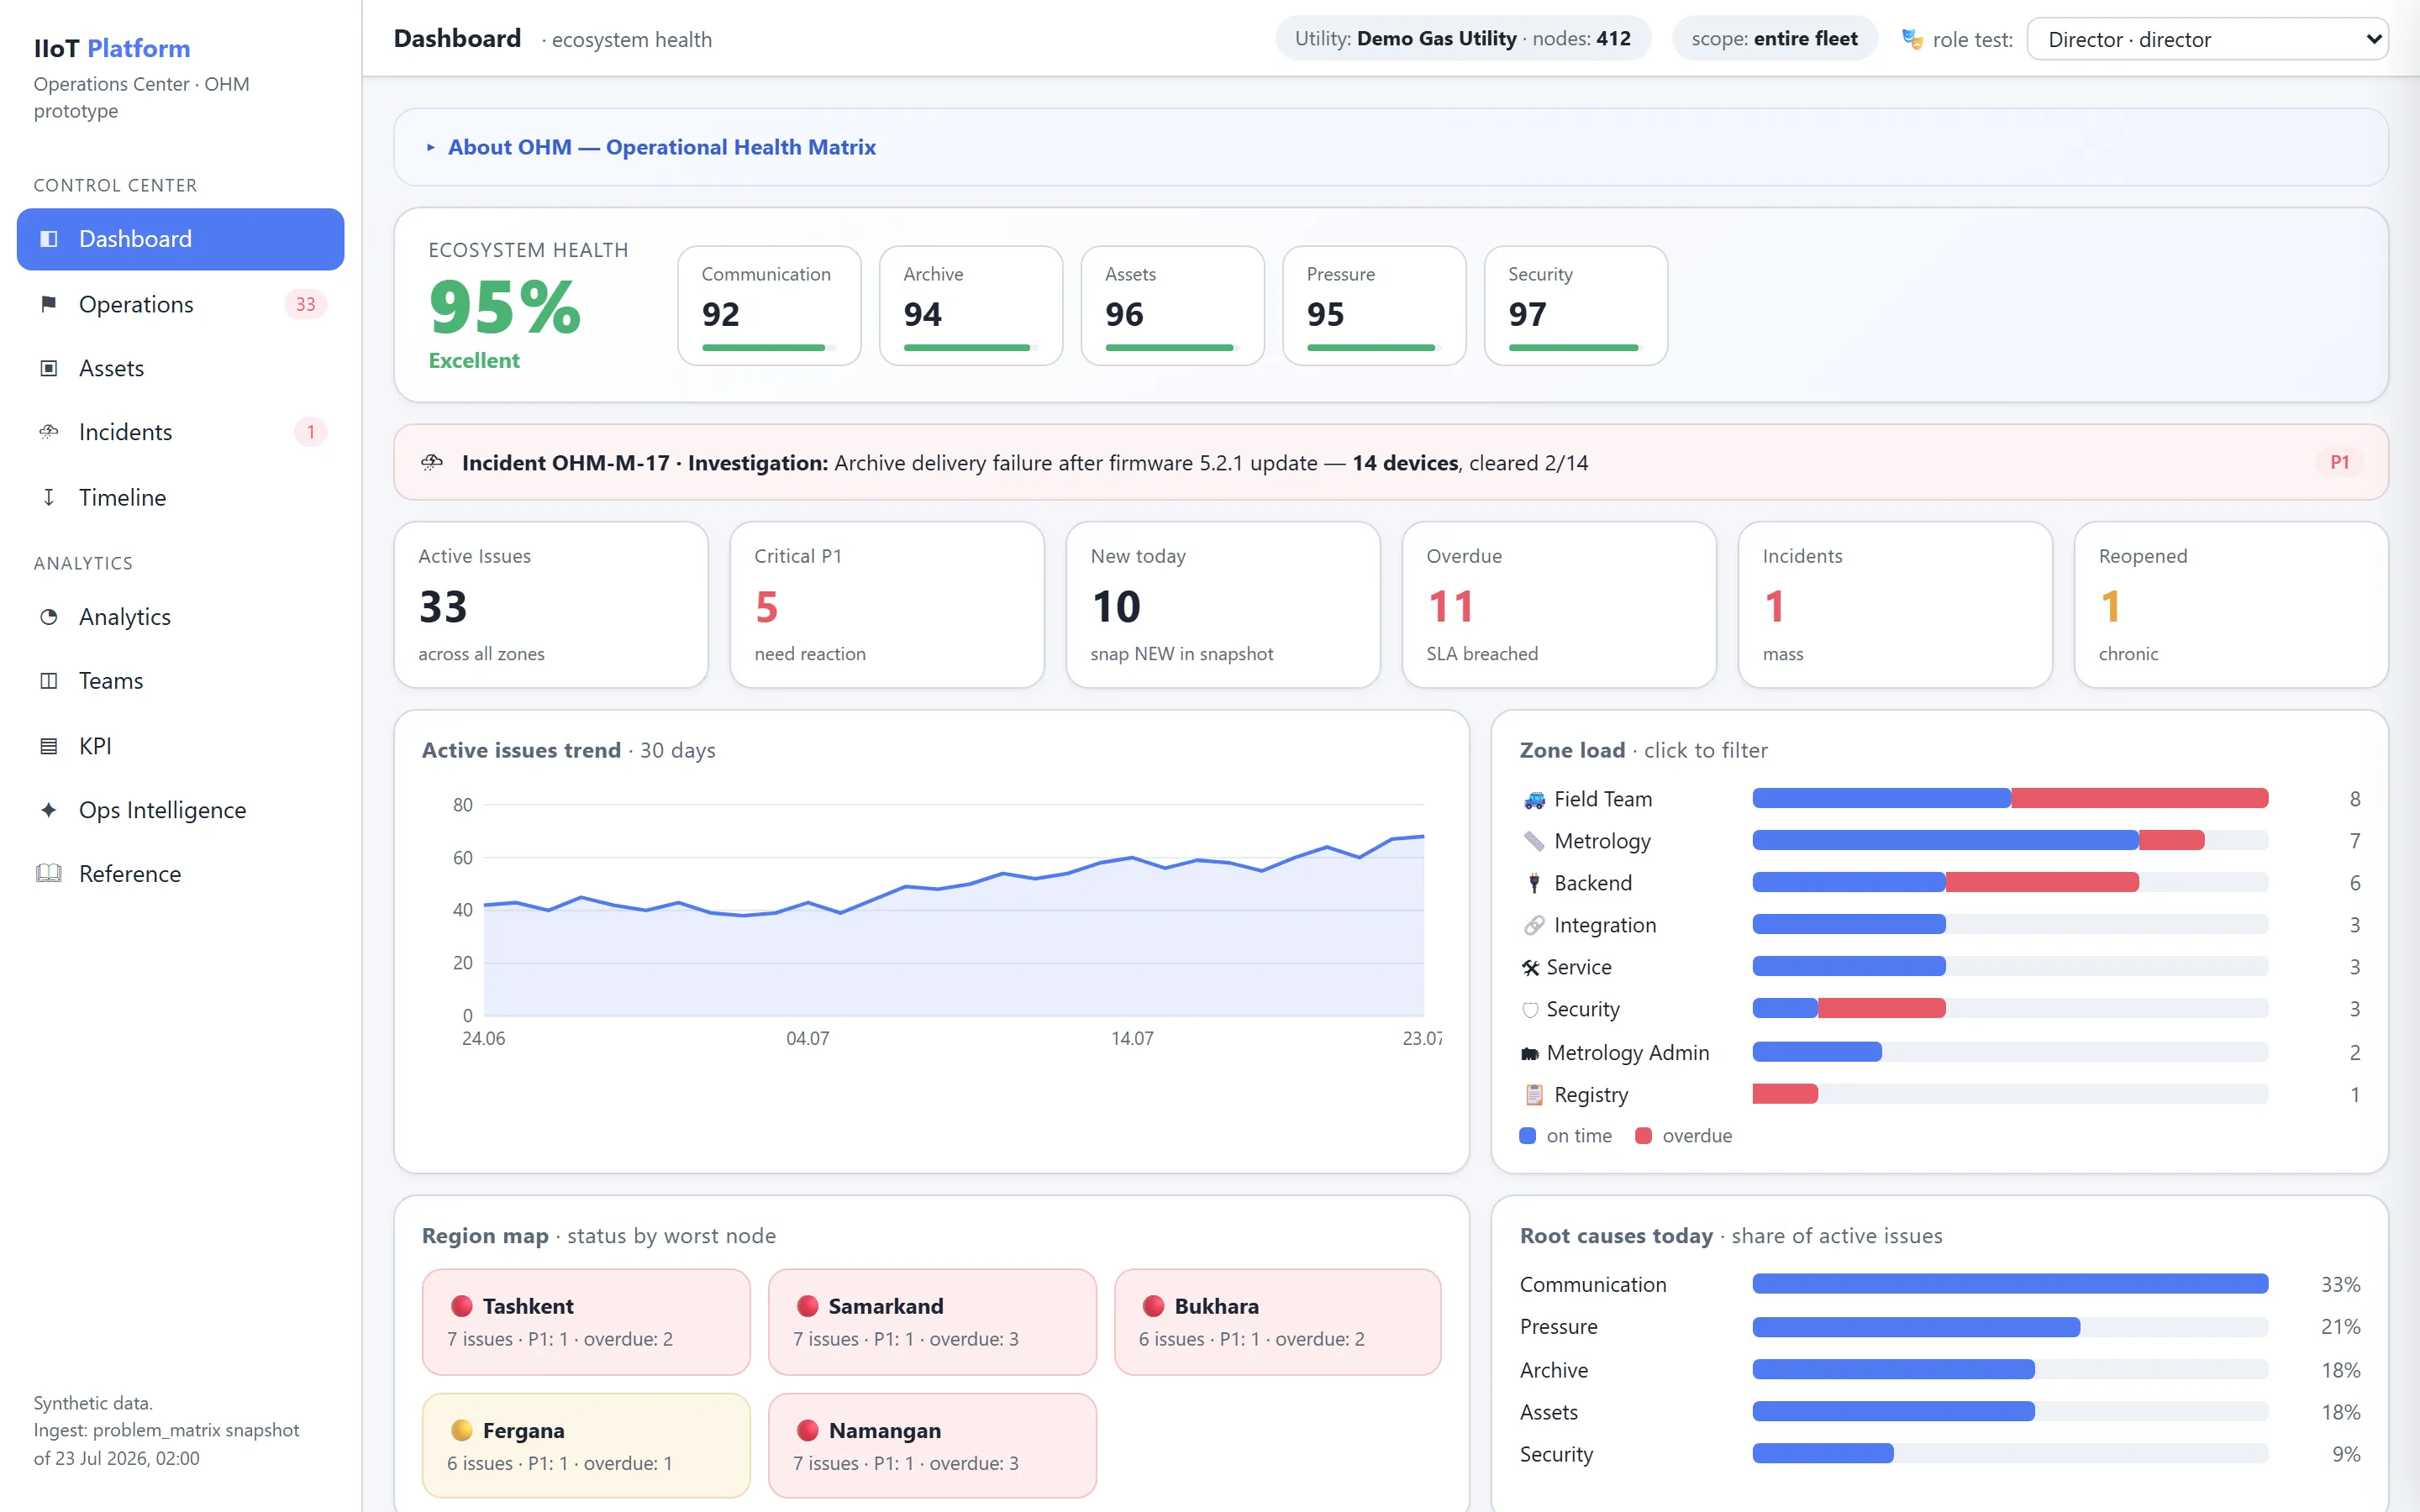
Scopul subsistemului
Sistemele tradiționale de telemetrie răspund bine la întrebarea:
Ce s-a întâmplat cu dispozitivul sau cu datele?
Acest lucru nu este însă suficient pentru a gestiona un parc mare de dispozitive. După detectarea unui eveniment, organizația trebuie să stabilească:
- dacă semnalul reprezintă o problemă reală;
- dacă afectează un singur dispozitiv sau este un incident care cuprinde întregul sistem;
- ce alte simptome sunt legate de aceeași cauză fundamentală;
- cine răspunde de rezolvare;
- până când trebuie încheiată lucrarea;
- ce acțiuni s-au întreprins deja;
- dacă rezolvarea a fost confirmată de date obiective;
- dacă problema este recurentă;
- cât de eficient funcționează procesul operațional.
OHM închide întregul ciclu.
Principalul rezultat al subsistemului nu este o notificare sau un rând dintr-un raport, ci o entitate operațională gestionată, care are:
- un identificator;
- un tip de problemă;
- active afectate;
- dovezi;
- un nivel de gravitate;
- un nivel de încredere;
- o cauză fundamentală probabilă și una confirmată;
- un responsabil;
- un executant;
- un termen;
- sarcini;
- un istoric;
- un status de verificare;
- un rezultat al rezolvării;
- o legătură cu baza de cunoștințe;
- un impact asupra KPI.
Avantajul principal
Platforma nu se oprește la înregistrarea abaterilor, ci urmărește problema până la un rezultat confirmat.
flowchart TD
  subgraph OPS["Data Platform și OHM"]
    direction TB
    O1["A detectat problema"] --> O2["A verificat dovezile"]
    O2 --> O3["A consolidat semnalele corelate"]
    O3 --> O4["A stabilit prioritatea"]
    O4 --> O5["A atribuit zona de responsabilitate"]
    O5 --> O6["Urmărește termenul"]
    O6 --> O7["A verificat rezultatul pe baza datelor"]
    O7 --> O8["A înregistrat soluția confirmată"]
  end
  subgraph MON["Sistem de monitorizare"]
    direction TB
    M1["A detectat problema"] --> M2["Aici se încheie activitatea sistemului"]
  end
Astfel, OHM trece activitatea operațională de la un regim reactiv la un model gestionat, în care fiecare abatere semnificativă are un responsabil, un termen, dovezi și un rezultat măsurabil.
Principii de bază
Probleme în locul alarmelor
O singură alarmă nu înseamnă întotdeauna o problemă operațională.
O singură defecțiune fizică poate genera zeci sau sute de evenimente:
- lipsa sesiunii de comunicație;
- lipsa arhivei;
- date neactualizate;
- starea bateriei necunoscută;
- lipsa valorii curente a presiunii;
- eroare de livrare.
OHM nu creează câte o lucrare separată pentru fiecare simptom. Sistemul corelează semnalele și, când acestea au o cauză comună, creează o singură entitate Operational Issue.
Exploatare bazată pe dovezi
Fiecare concluzie automată trebuie să poată fi explicată.
O problemă (Issue) conține:
- valorile din sursă;
- mărcile temporale;
- identificatorul detectorului;
- versiunea algoritmului;
- pragurile aplicate;
- o legătură către raportul specializat relevant;
- istoricul recurențelor;
- semnalele corelate;
- rezultatul corelării.
Utilizatorii pot urmări oricând drumul de la telemetria brută până la problema creată.
Mai întâi cauza fundamentală
OHM face distincția între:
- un simptom – o abatere observată;
- o cauză – factorul tehnic sau organizațional care a produs abaterea;
- o cauză fundamentală (Root Cause) – factorul inițial a cărui eliminare previne reapariția unui grup de simptome.
Exemplu:
flowchart LR
  S1["Simptomul 1: lipsește arhiva orară"] --> RC["Cauză fundamentală probabilă: degradarea sursei de alimentare"]
  S2["Simptomul 2: ultima sesiune a avut loc acum 9 zile"] --> RC
  S3["Simptomul 3: tensiunea bateriei scădea"] --> RC
  S4["Simptomul 4: durata sesiunii creștea"] --> RC
Închidere verificată pe baza datelor
Executantul raportează că lucrarea este încheiată, dar statusul final resolved se stabilește numai după verificarea rezultatului.
flowchart TD
  V1["Lucrare încheiată"] --> V2["awaiting_verification"]
  V2 --> V3["Datele noi confirmă revenirea la normal"]
  V3 --> V4["resolved"]
Pentru problemele care nu pot fi verificate prin telemetrie, se aplică o verificare manuală controlată, cu comentariu obligatoriu și dovezi justificative.
Perspectivă centrată pe active
Toate evenimentele, problemele, lucrările și indicatorii sunt legați de active (Asset):
- puncte de măsurare;
- corectoare;
- contoare;
- senzori;
- modemuri;
- gateway-uri;
- cartele SIM;
- componente de server;
- canale de integrare;
- versiuni de software.
Fișa activului afișează starea curentă, istoricul degradării, problemele active, lucrările încheiate și recurența problemelor.
Omul răspunde, IA asistă
IA ajută la:
- rezumarea dovezilor (Evidence);
- ierarhizarea ipotezelor;
- găsirea cazurilor similare;
- propunerea soluțiilor cunoscute;
- identificarea unor grupări noi;
- prognoza riscului de defectare.
IA nu poate, de una singură:
- să schimbe prioritatea;
- să atribuie responsabilitatea;
- să închidă o problemă;
- să confirme o cauză fundamentală ca fapt stabilit;
- să modifice termenele SLA;
- să execute acțiuni critice asupra echipamentelor.
Reproductibilitate încă din faza de proiectare
Toate calculele semnificative sunt reproductibile. Pentru fiecare rezultat, platforma stochează:
- versiunea detectorului;
- versiunea problemei canonice (Canon);
- versiunea modelului de corelare;
- setul de date utilizat;
- momentul calculului;
- pragurile;
- configurația;
- sursa modificării.
OHM în arhitectura Data Platform
OHM se situează între nivelul de analiză și gestionarea activității operaționale.
flowchart TD
  PHY["Active fizice"] --> DATA["Nivelul datelor IIoT și al integrării"]
  DATA -->|"Date normalizate"| ANL["Analiză și detectare"]
  ANL -->|"Evidence și constatări"| OHM["Operational Health Matrix"]
  OHM -->|"API, evenimente, integrare"| ENT["Sisteme de întreprindere"]
Componența nivelurilor:
| Nivel | Componente |
|---|---|
| Active fizice | contoare, corectoare, senzori, gateway-uri, vane |
| Nivelul datelor IIoT și al integrării | telemetrie, arhive, registru, cărți tehnice, evenimente |
| Analiză și detectare | detectoare de probleme canonice, rapoarte aprofundate, IA, corelare |
| Operational Health Matrix | Issues, Tasks, SLA, verificare, KPI, baza de cunoștințe |
| Sisteme de întreprindere | ERP, EAM, CMMS, Service Desk, BI, notificări |
Surse de date
OHM folosește:
- telemetria curentă;
- arhivele orare, zilnice și de evenimente;
- jurnalele sesiunilor de comunicație;
- datele din cartea tehnică și din registru;
- stările dispozitivelor;
- datele despre baterii;
- presiunea, temperatura, debitul și volumul;
- evenimentele de intervenție neautorizată;
- versiunile de firmware;
- parametrii de comunicație;
- rezultatele rapoartelor specializate;
- observațiile manuale ale utilizatorilor;
- evenimentele din sistemele externe.
Surse de dovezi
Orice componentă analitică a platformei poate servi drept sursă de dovezi.
Exemple:
| Sursă de dovezi | Ce transmite subsistemului OHM |
|---|---|
| Matricea problemelor din parcul de dispozitive | probleme canonice și statusuri zilnice |
| Analiza arhivei orare | grad de completare, goluri, gol final (de la sfârșitul perioadei), fiabilitatea datelor |
| Analiza sesiunilor | durată, frecvență, anomalii de comunicație |
| Analiza presiunii | valori în afara intervalului admis, salturi, valori blocate |
| Analiza temperaturii | anomalii, discrepanțe, plauzibilitate fizică |
| Suspiciune de intervenție neautorizată | semnale de suspiciune și nivel de încredere |
| Analiza bateriilor | evoluție, praguri, prognoza duratei de viață rămase |
| Controlul cărților tehnice | parametri lipsă și contradictorii |
| Controlul registrului | duplicate, înregistrări fantomă, neconcordanțe ale identificatorilor |
| Analiza versiunilor de firmware | grupări de probleme pe versiuni de software |
Explorați subsistemul
Tablourile de bord pe roluri, cozile și ecranele în care lucrează echipele în fiecare zi.
Entitățile de bază – Asset, Detector, Evidence, Issue, Task – și relațiile dintre ele.
Entitatea Operational Issue și statusurile ei, de la detectare până la închiderea verificată pe baza datelor.
Cum transformă detectoarele telemetria în definiții versionate ale problemelor canonice.
Dovezi imuabile, corelarea simptomelor și identificarea cauzei fundamentale probabile.
Cum gravitatea și impactul determină prioritatea, cronometrele SLA și căile de escaladare.
Sarcinile, atribuirile, comentariile și coada de sarcini prin care se ajunge la rezolvare.
Scorurile de stare calculate pentru active, amplasamente, regiuni și întregul ecosistem.
Indicatorii care măsoară procesul operațional și echipele care îl desfășoară.
Soluțiile confirmate, acumulate și reutilizate pentru problemele recurente.
Rezumare, ierarhizare și prognoză asistate de IA, fără drept de decizie.
Gruparea problemelor corelate într-o singură entitate – un incident de mare amploare.
Interfețe API, sisteme externe, controlul accesului și cerințe de audit.
Subiecte conexe
A fost utilă această pagină?
Vă mulțumim pentru răspuns!