Spații de lucru și ecrane
Spațiile de lucru pe roluri pentru directori, șefi de zonă, ingineri, metrologi și personal de securitate, ecranele principale ale Centrului operațional și modul în care perimetrul aplicat pe partea de server determină ce vede fiecare rol.
Spații de lucru pe roluri
Subsistemul OHM adaptează interfața, indicatorii și seturile de date afișate la rolul utilizatorului.
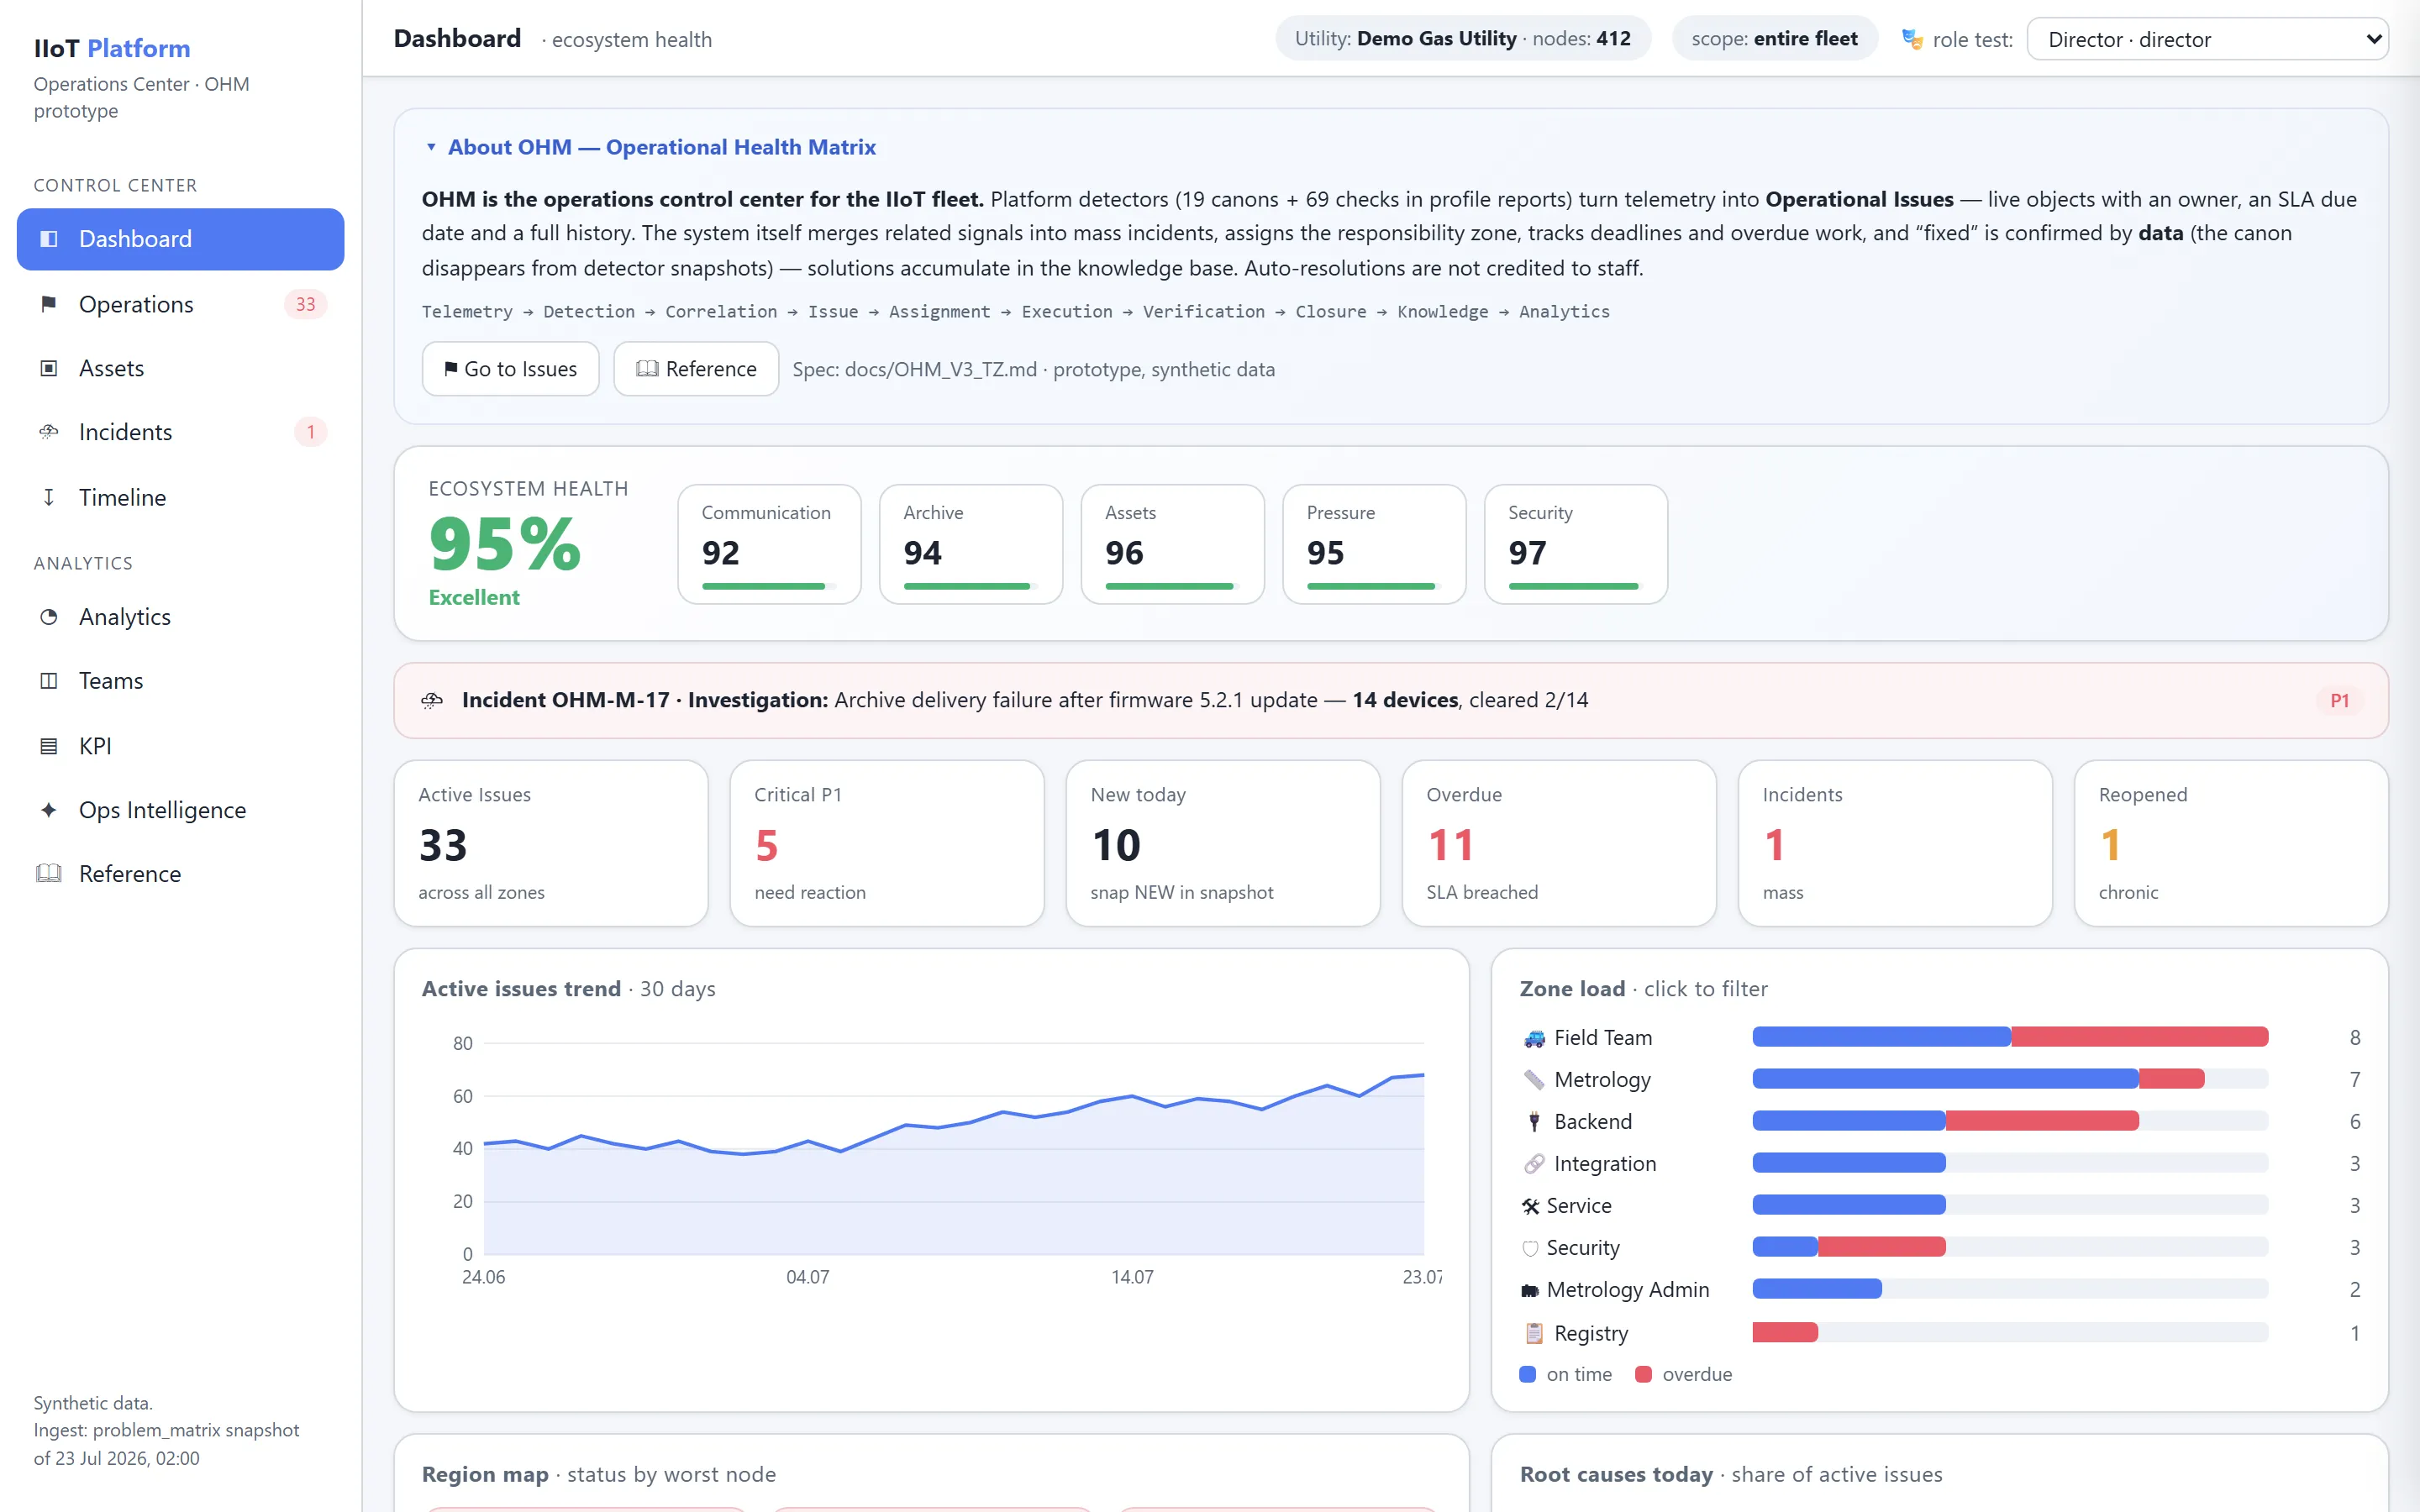
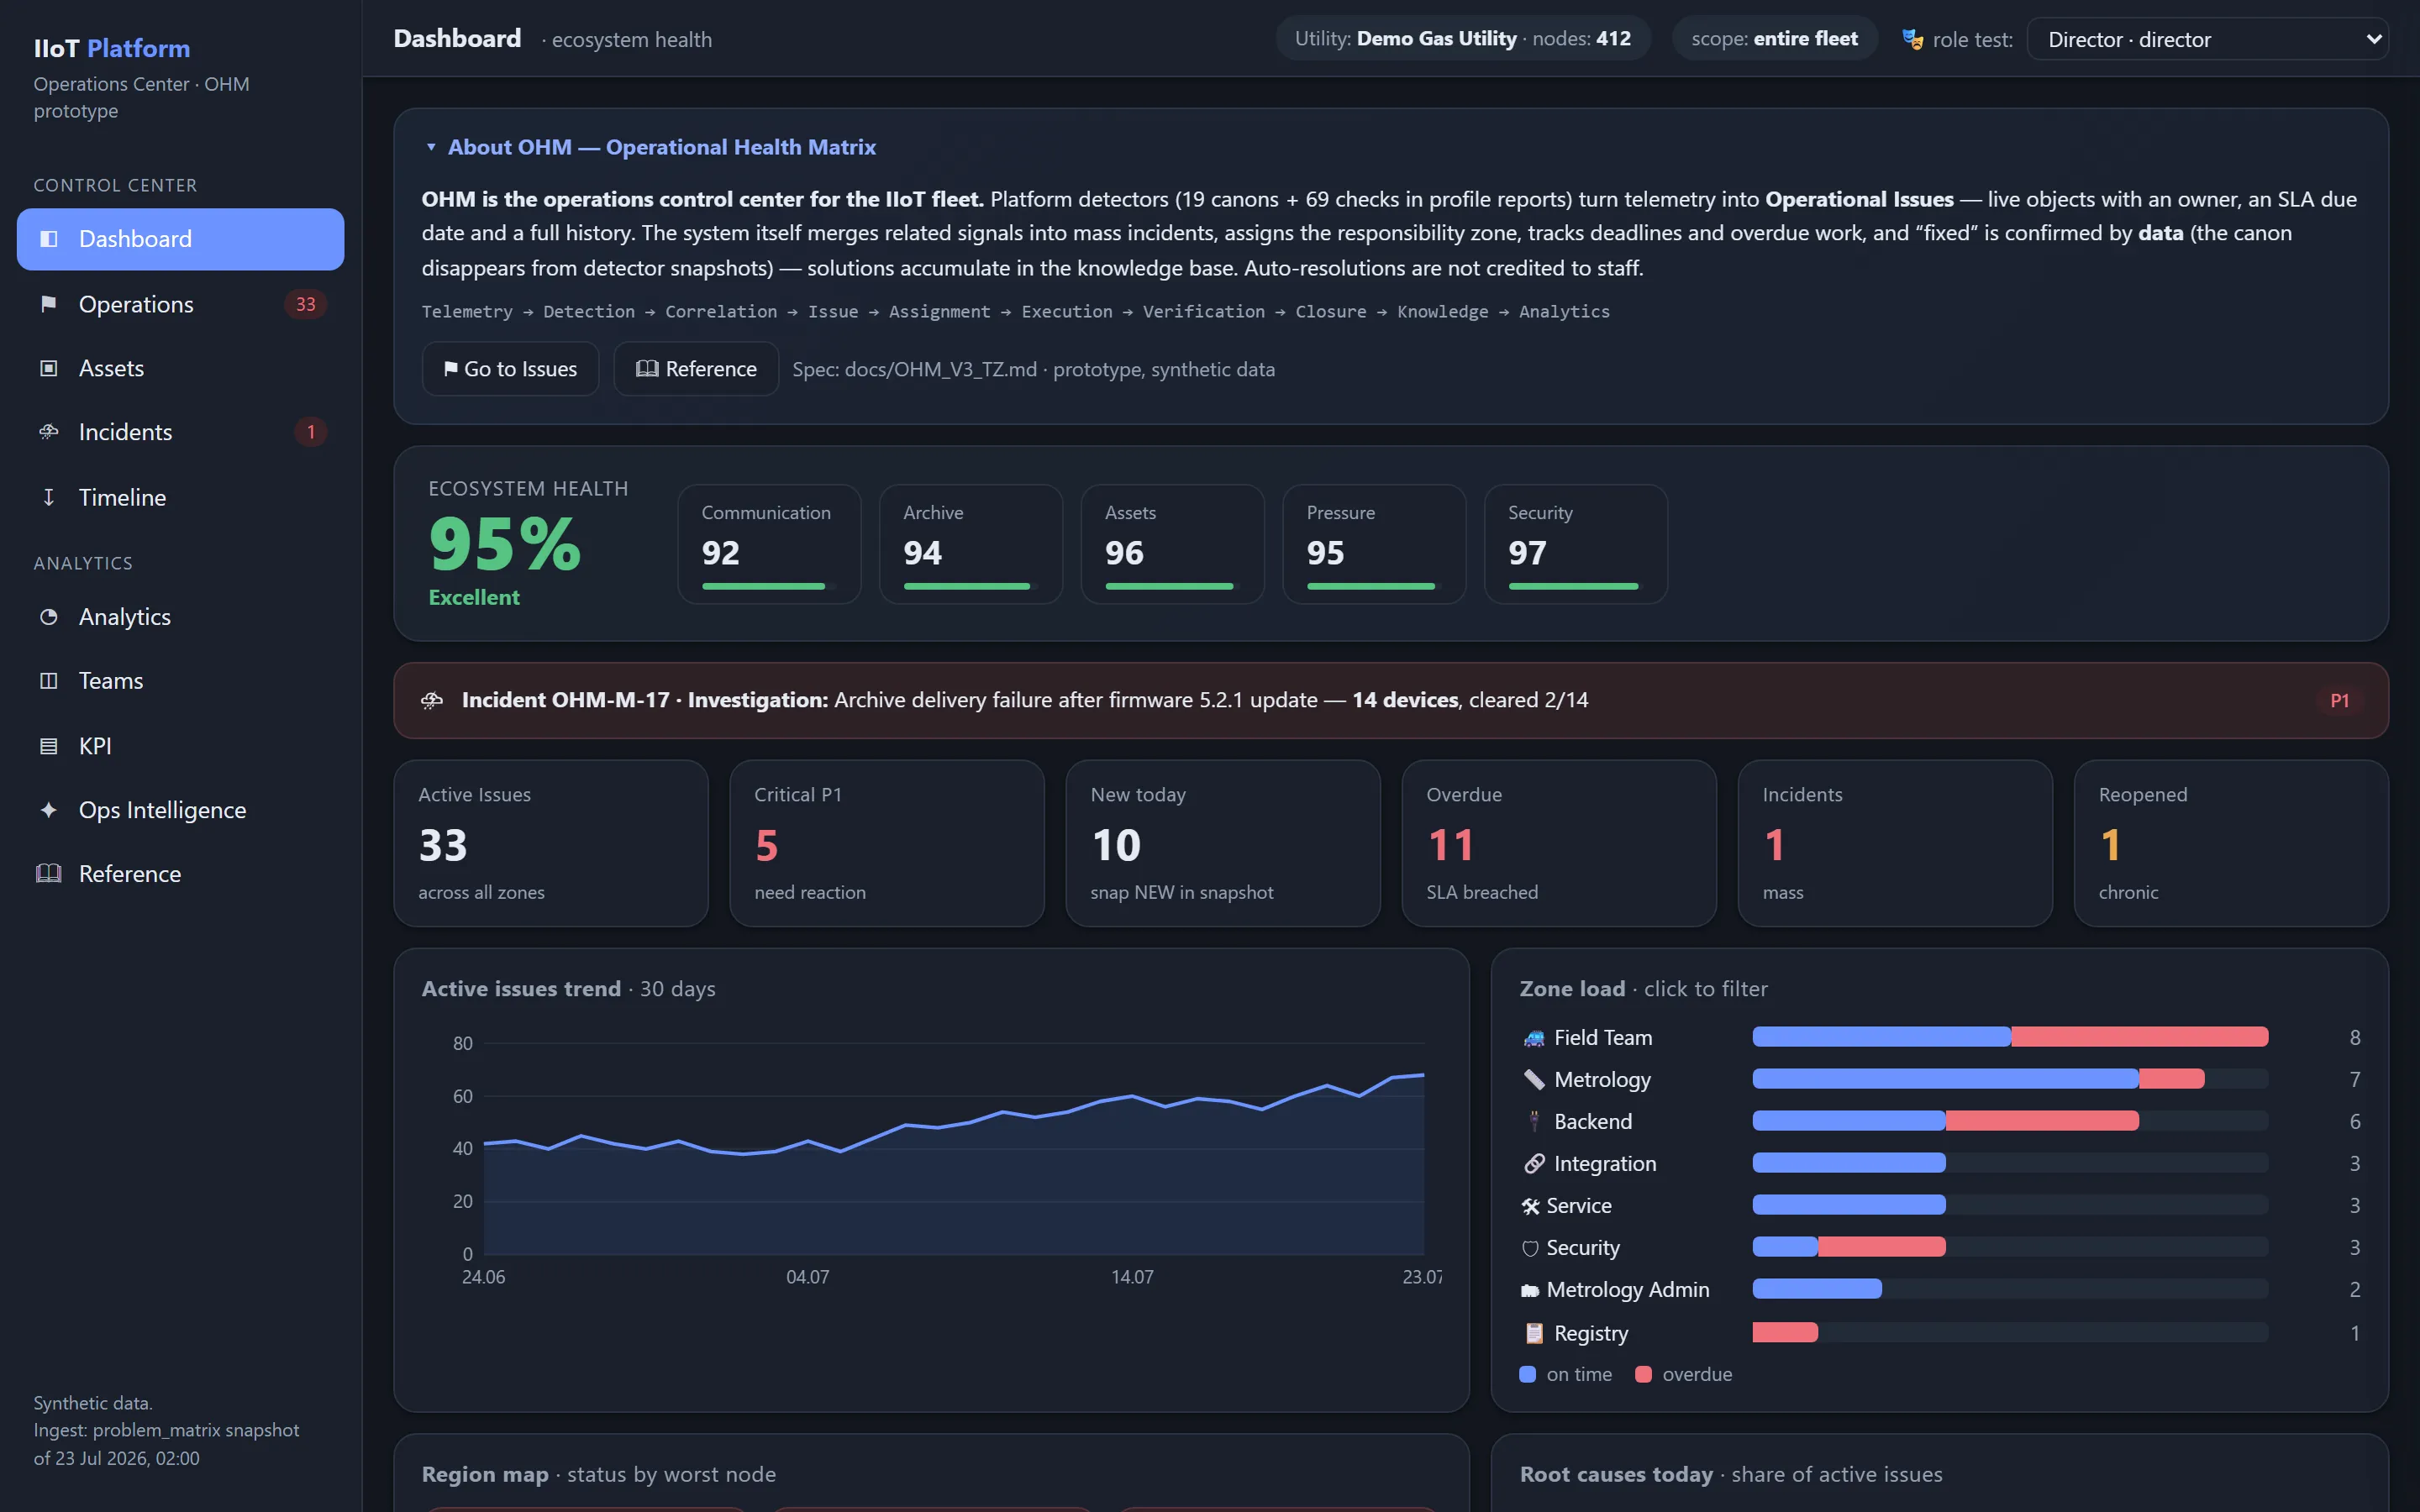
Director
Vede:
- starea ecosistemului (Ecosystem Health);
- problemele (Issues) critice;
- incidentele masive (Massive Incidents);
- încălcările termenelor din acordul privind nivelul serviciilor (SLA);
- distribuția pe regiuni;
- cauzele fundamentale (Root Causes);
- evoluția sarcinilor restante;
- riscurile-cheie;
- încărcarea departamentelor;
- problemele prognozate.
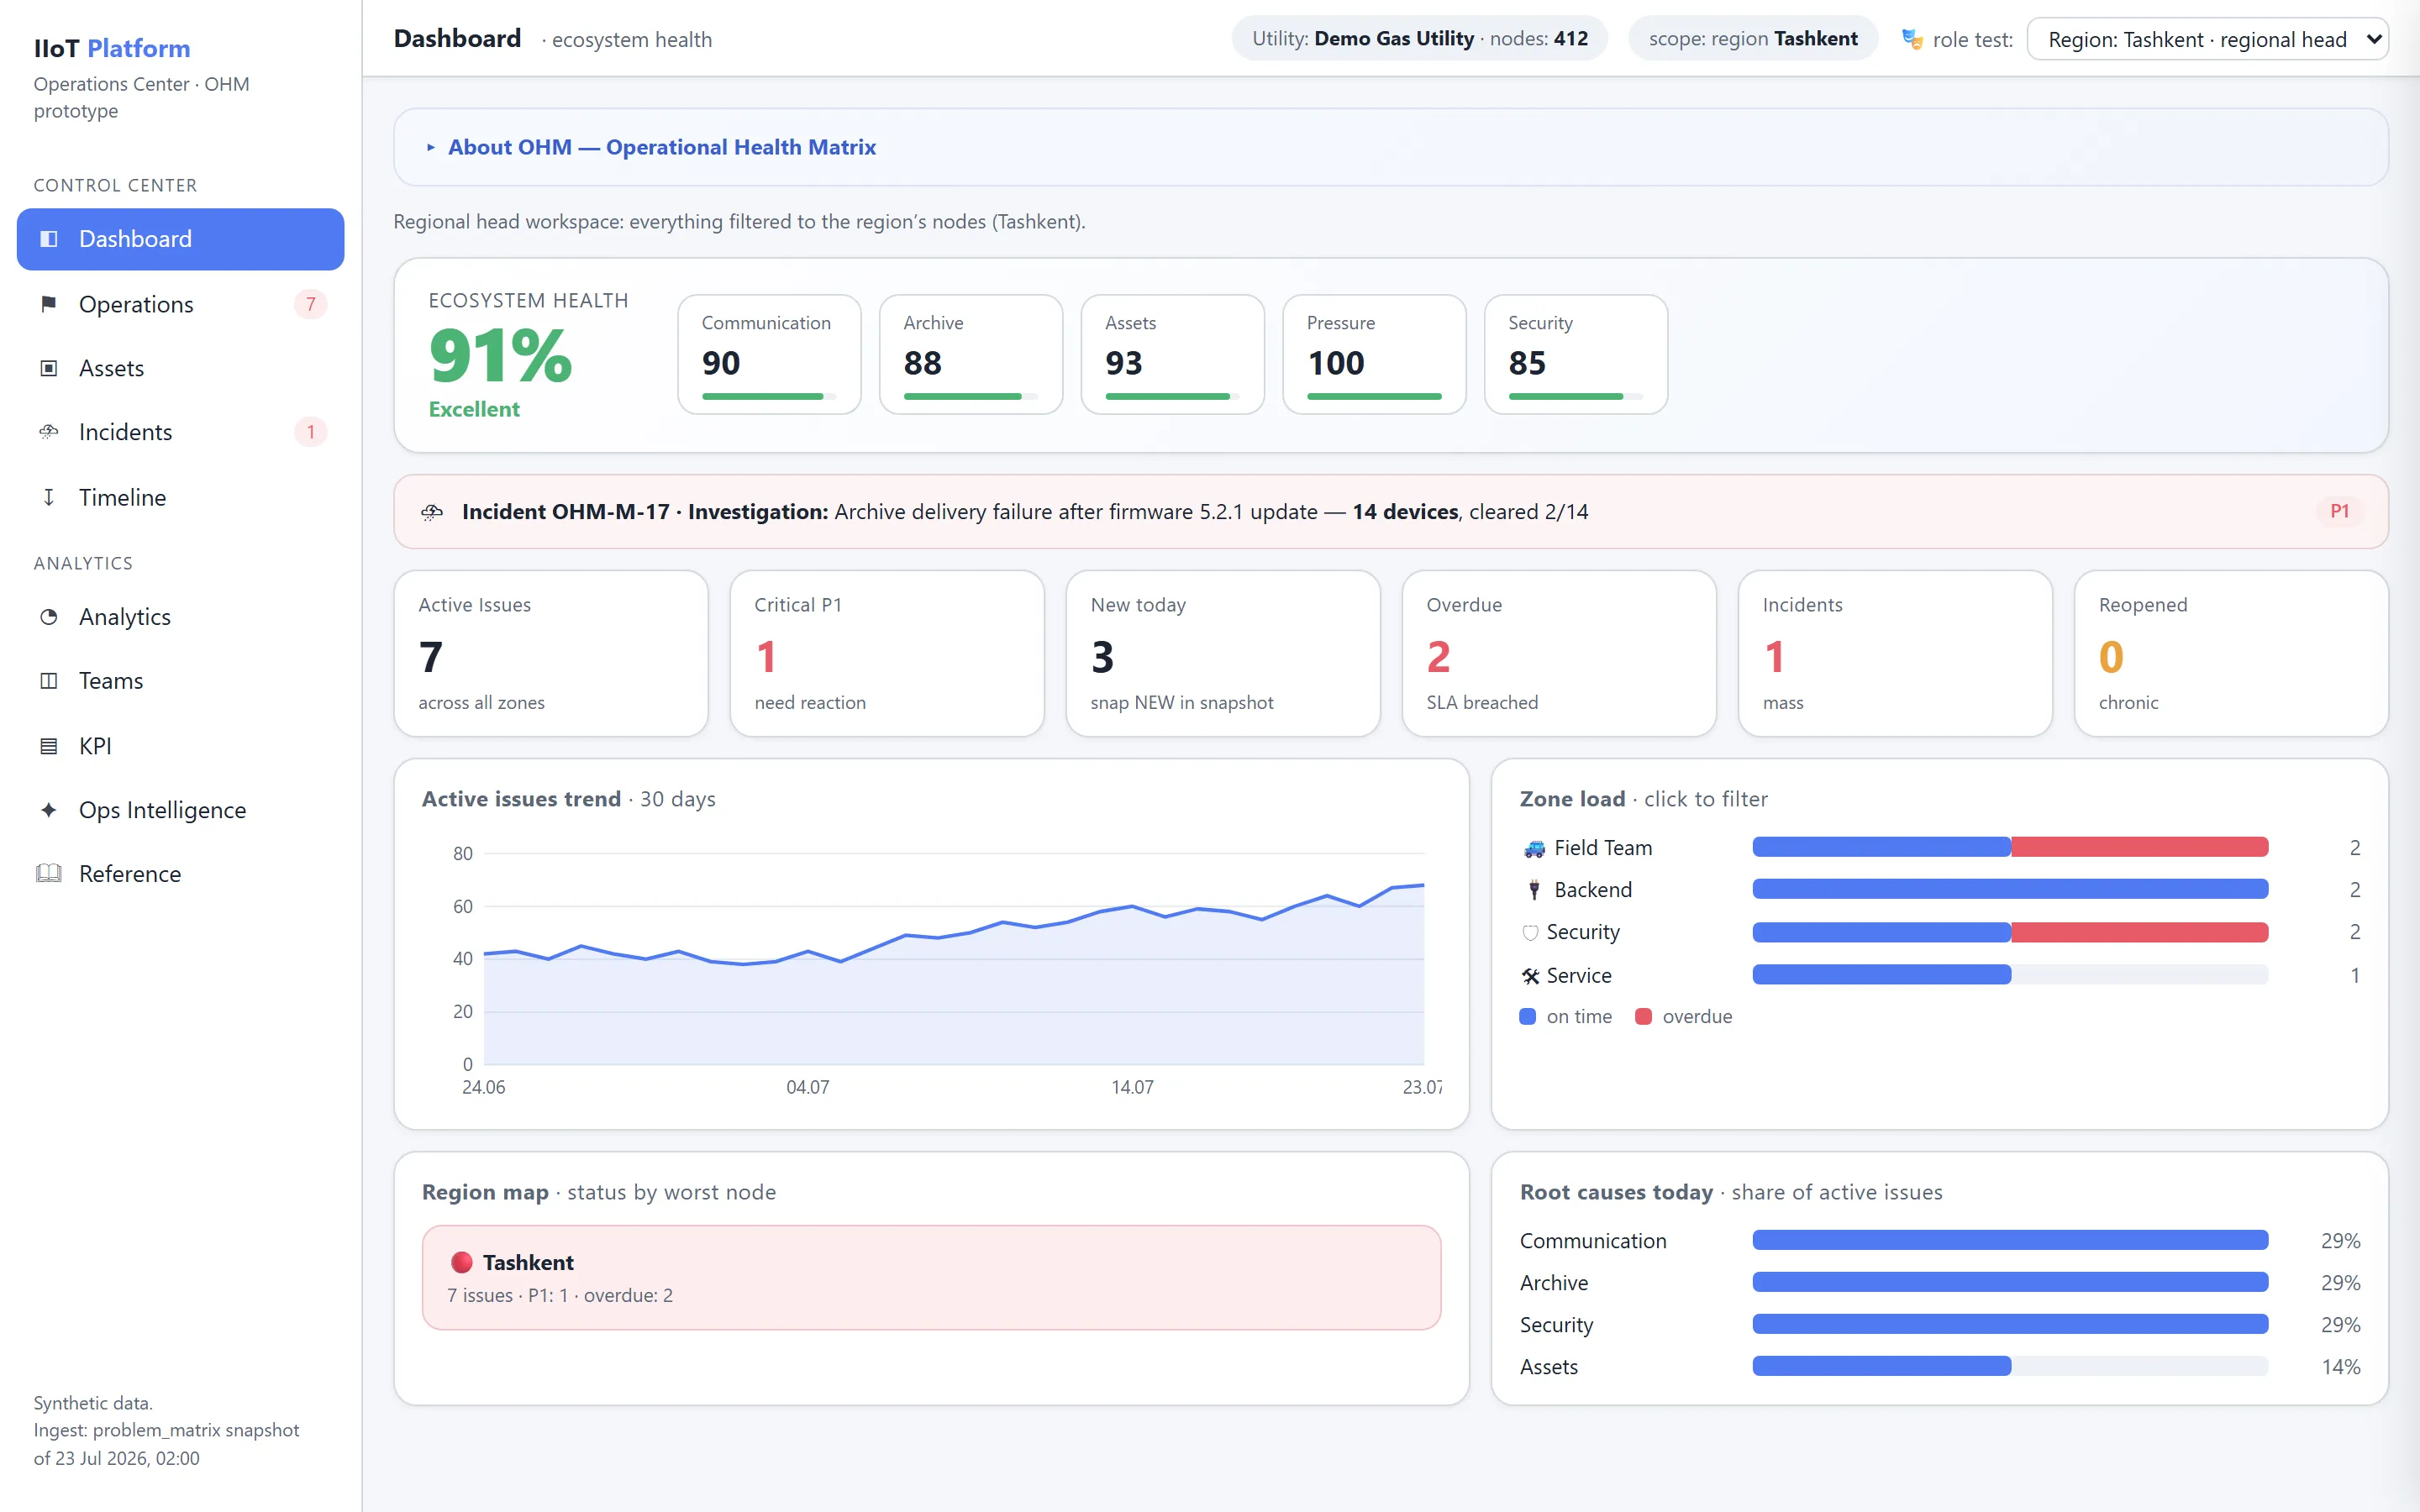
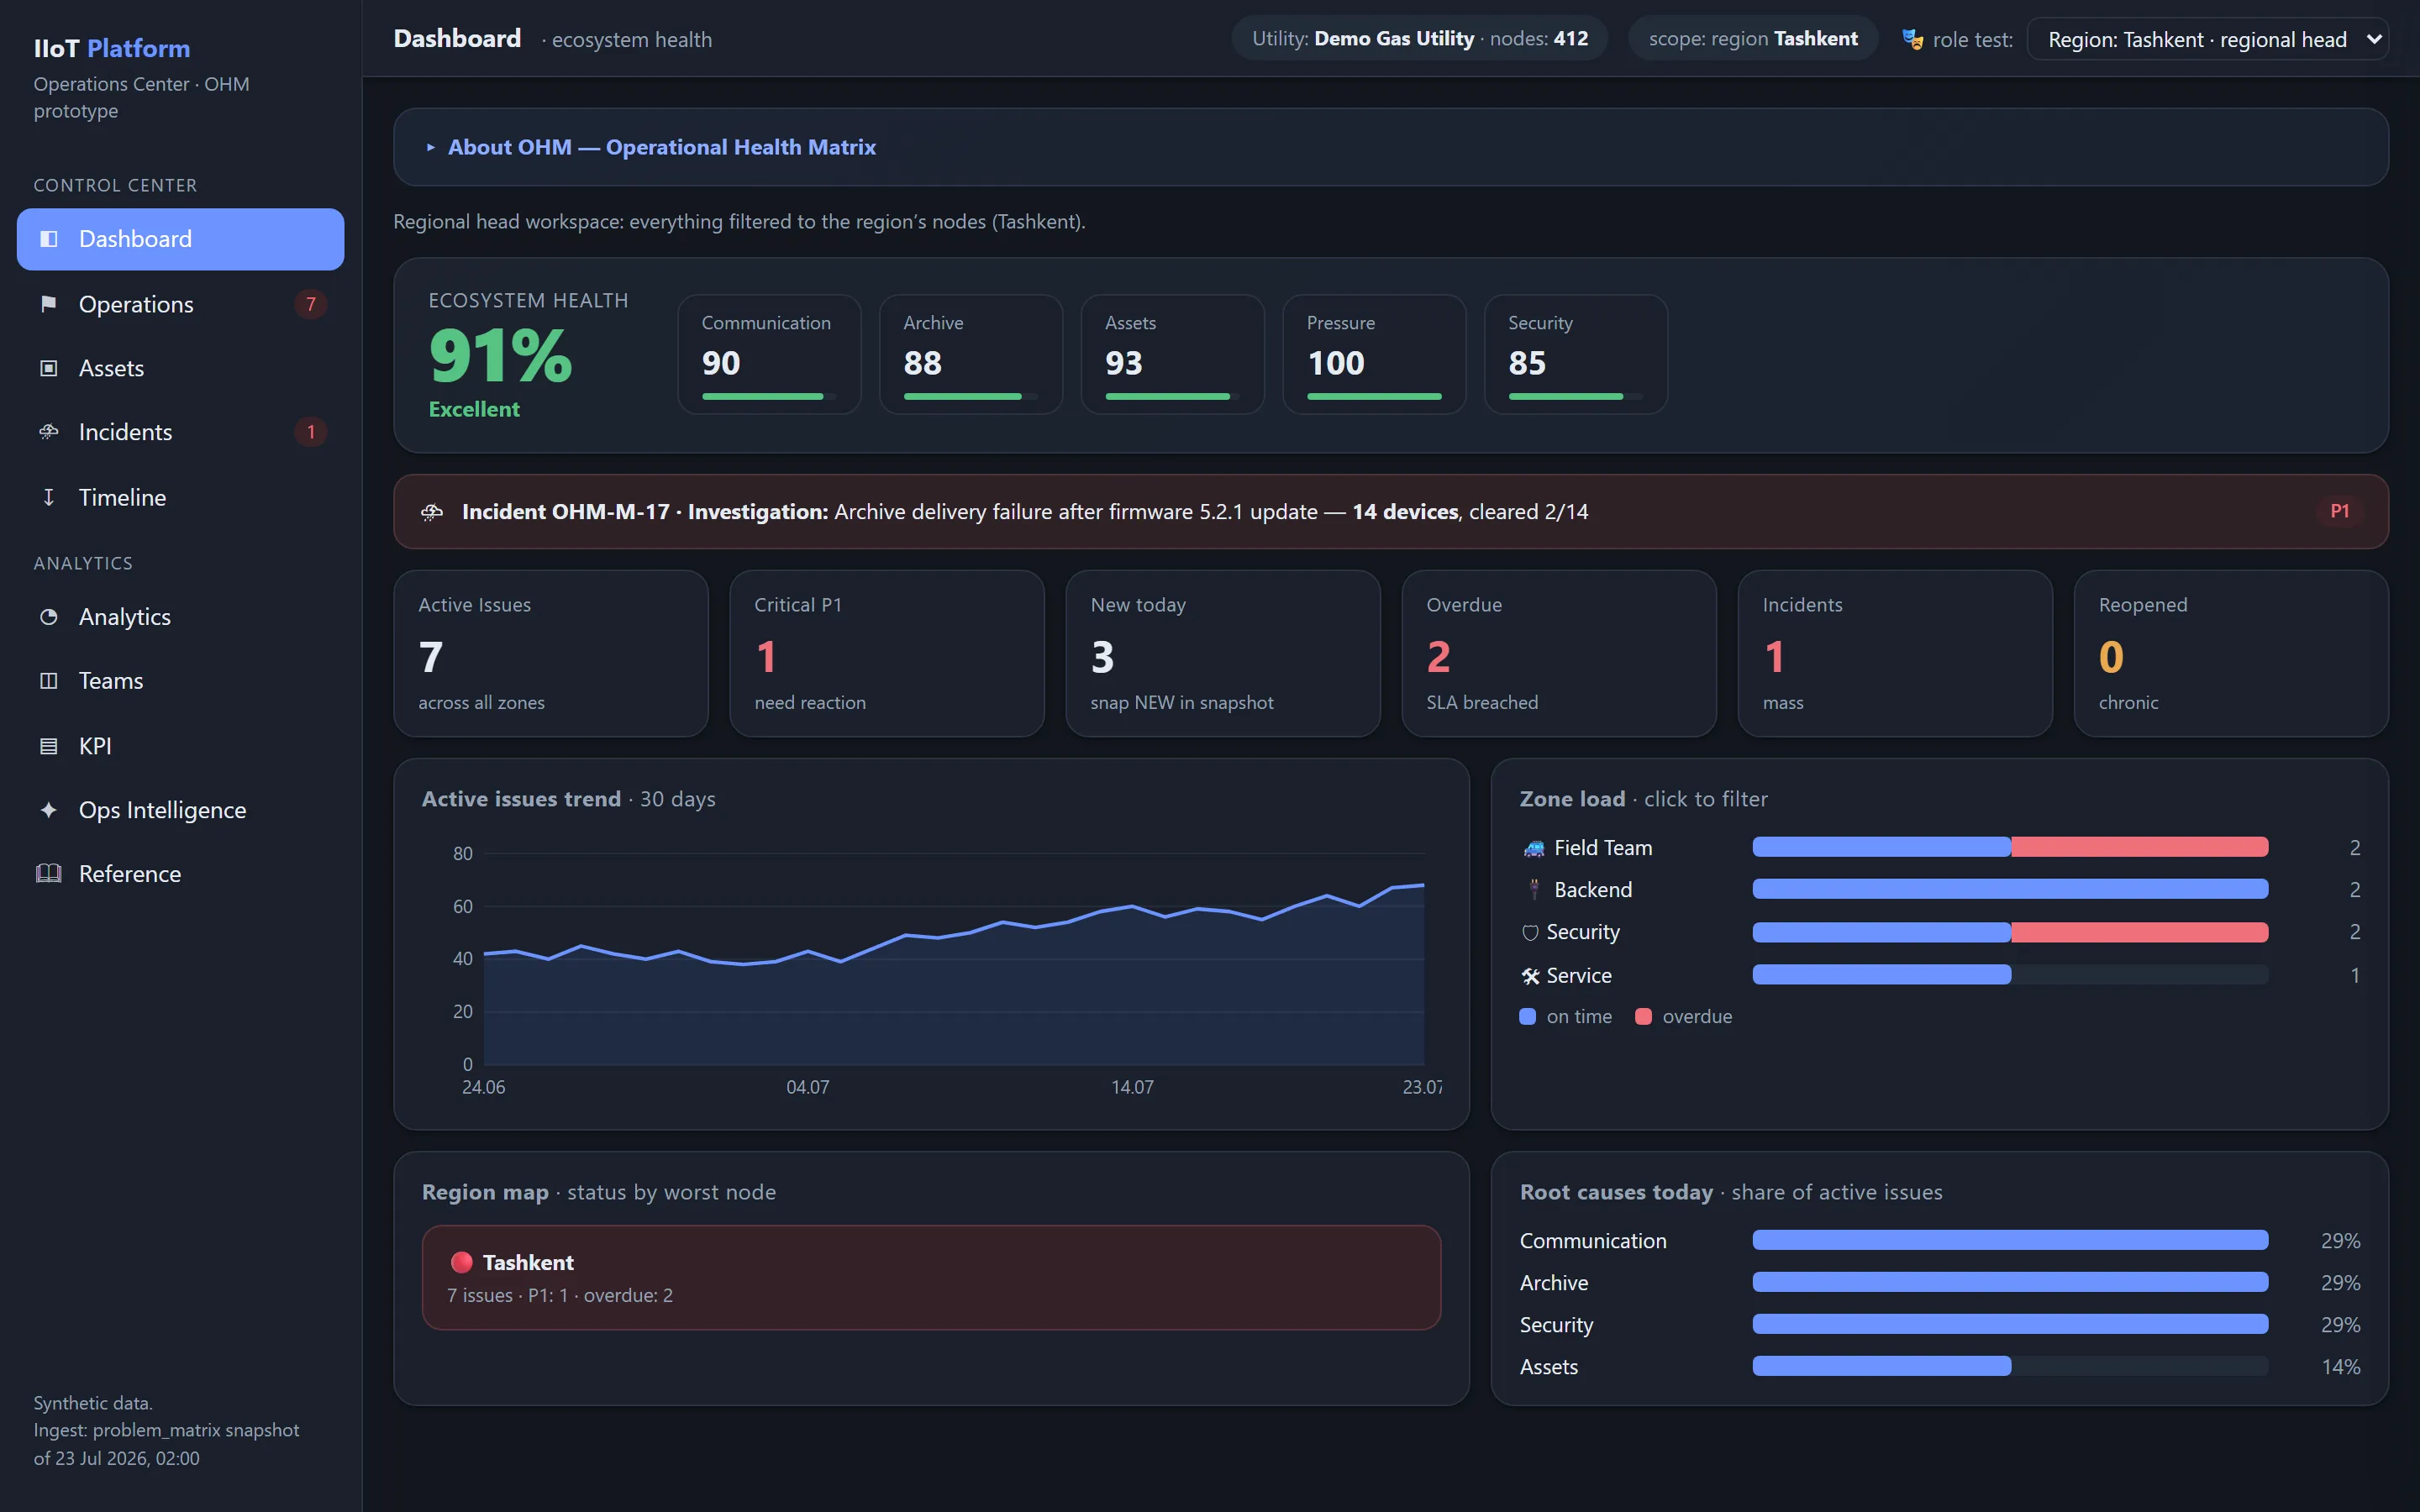
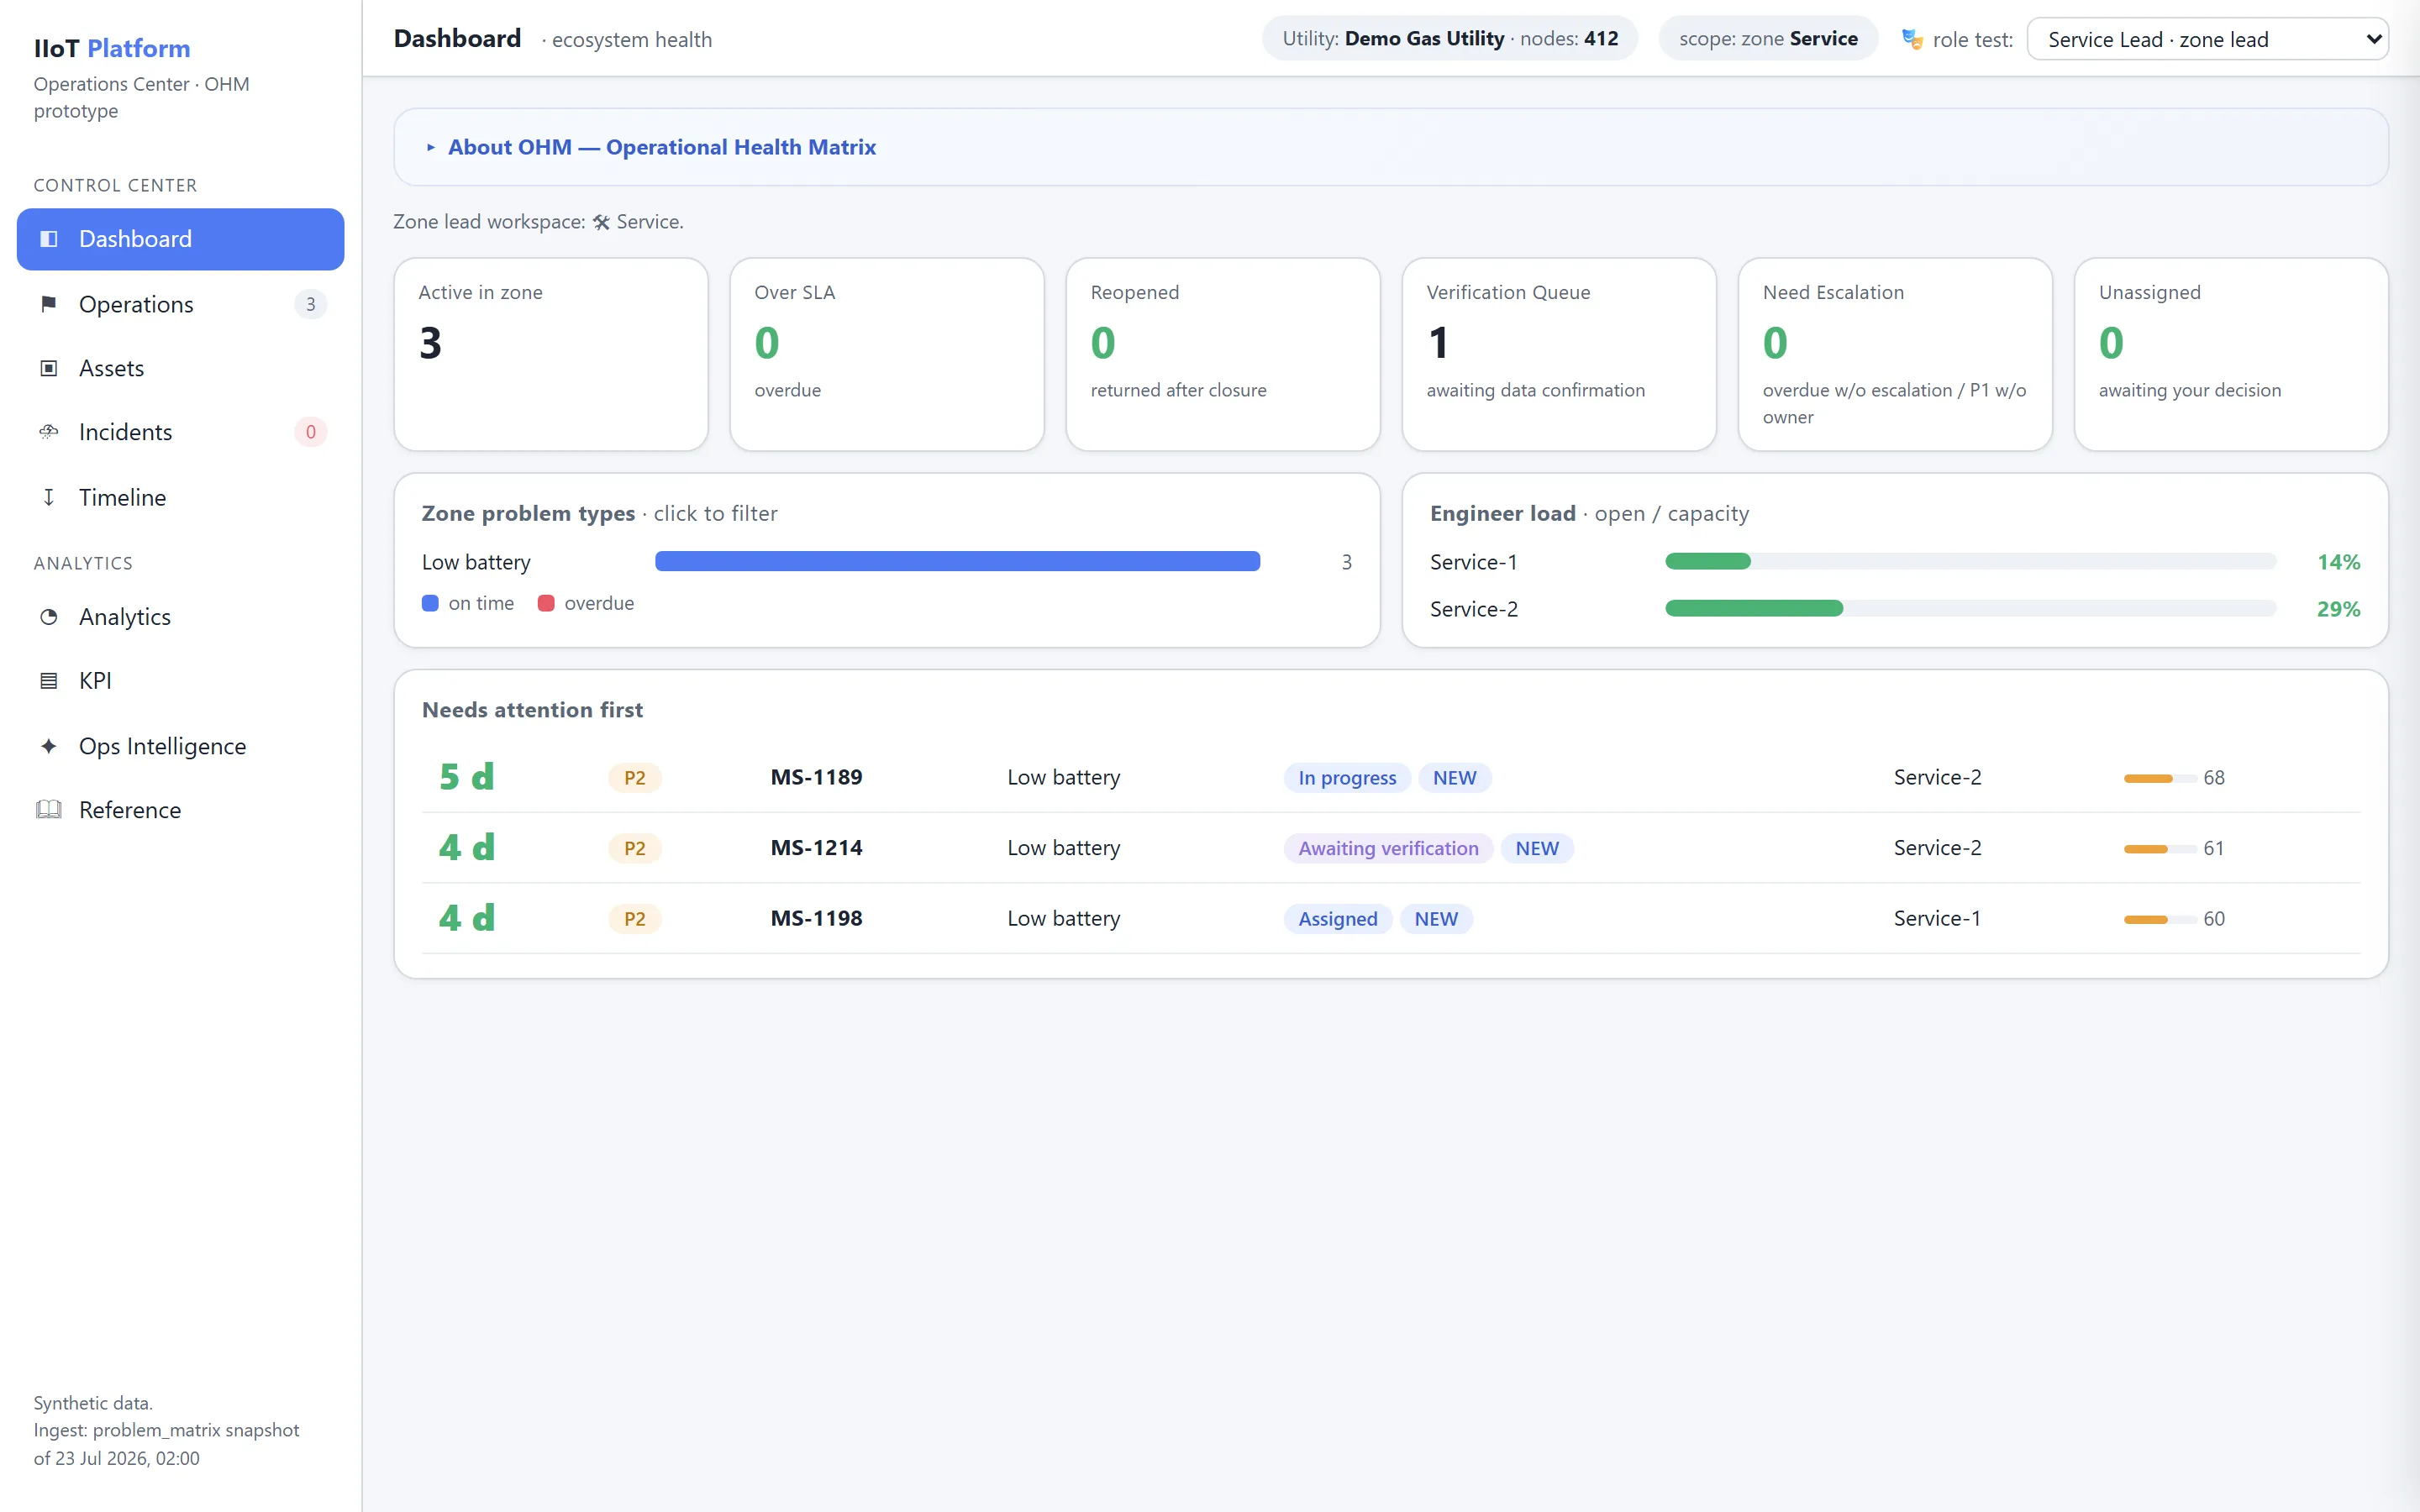
Șef de zonă
Vede:
- problemele din zona sa;
- lucrările neatribuite;
- problemele în afara termenului SLA (Over SLA);
- problemele redeschise (Reopened);
- coada de verificare (Verification Queue);
- problemele care necesită escaladare (Need Escalation);
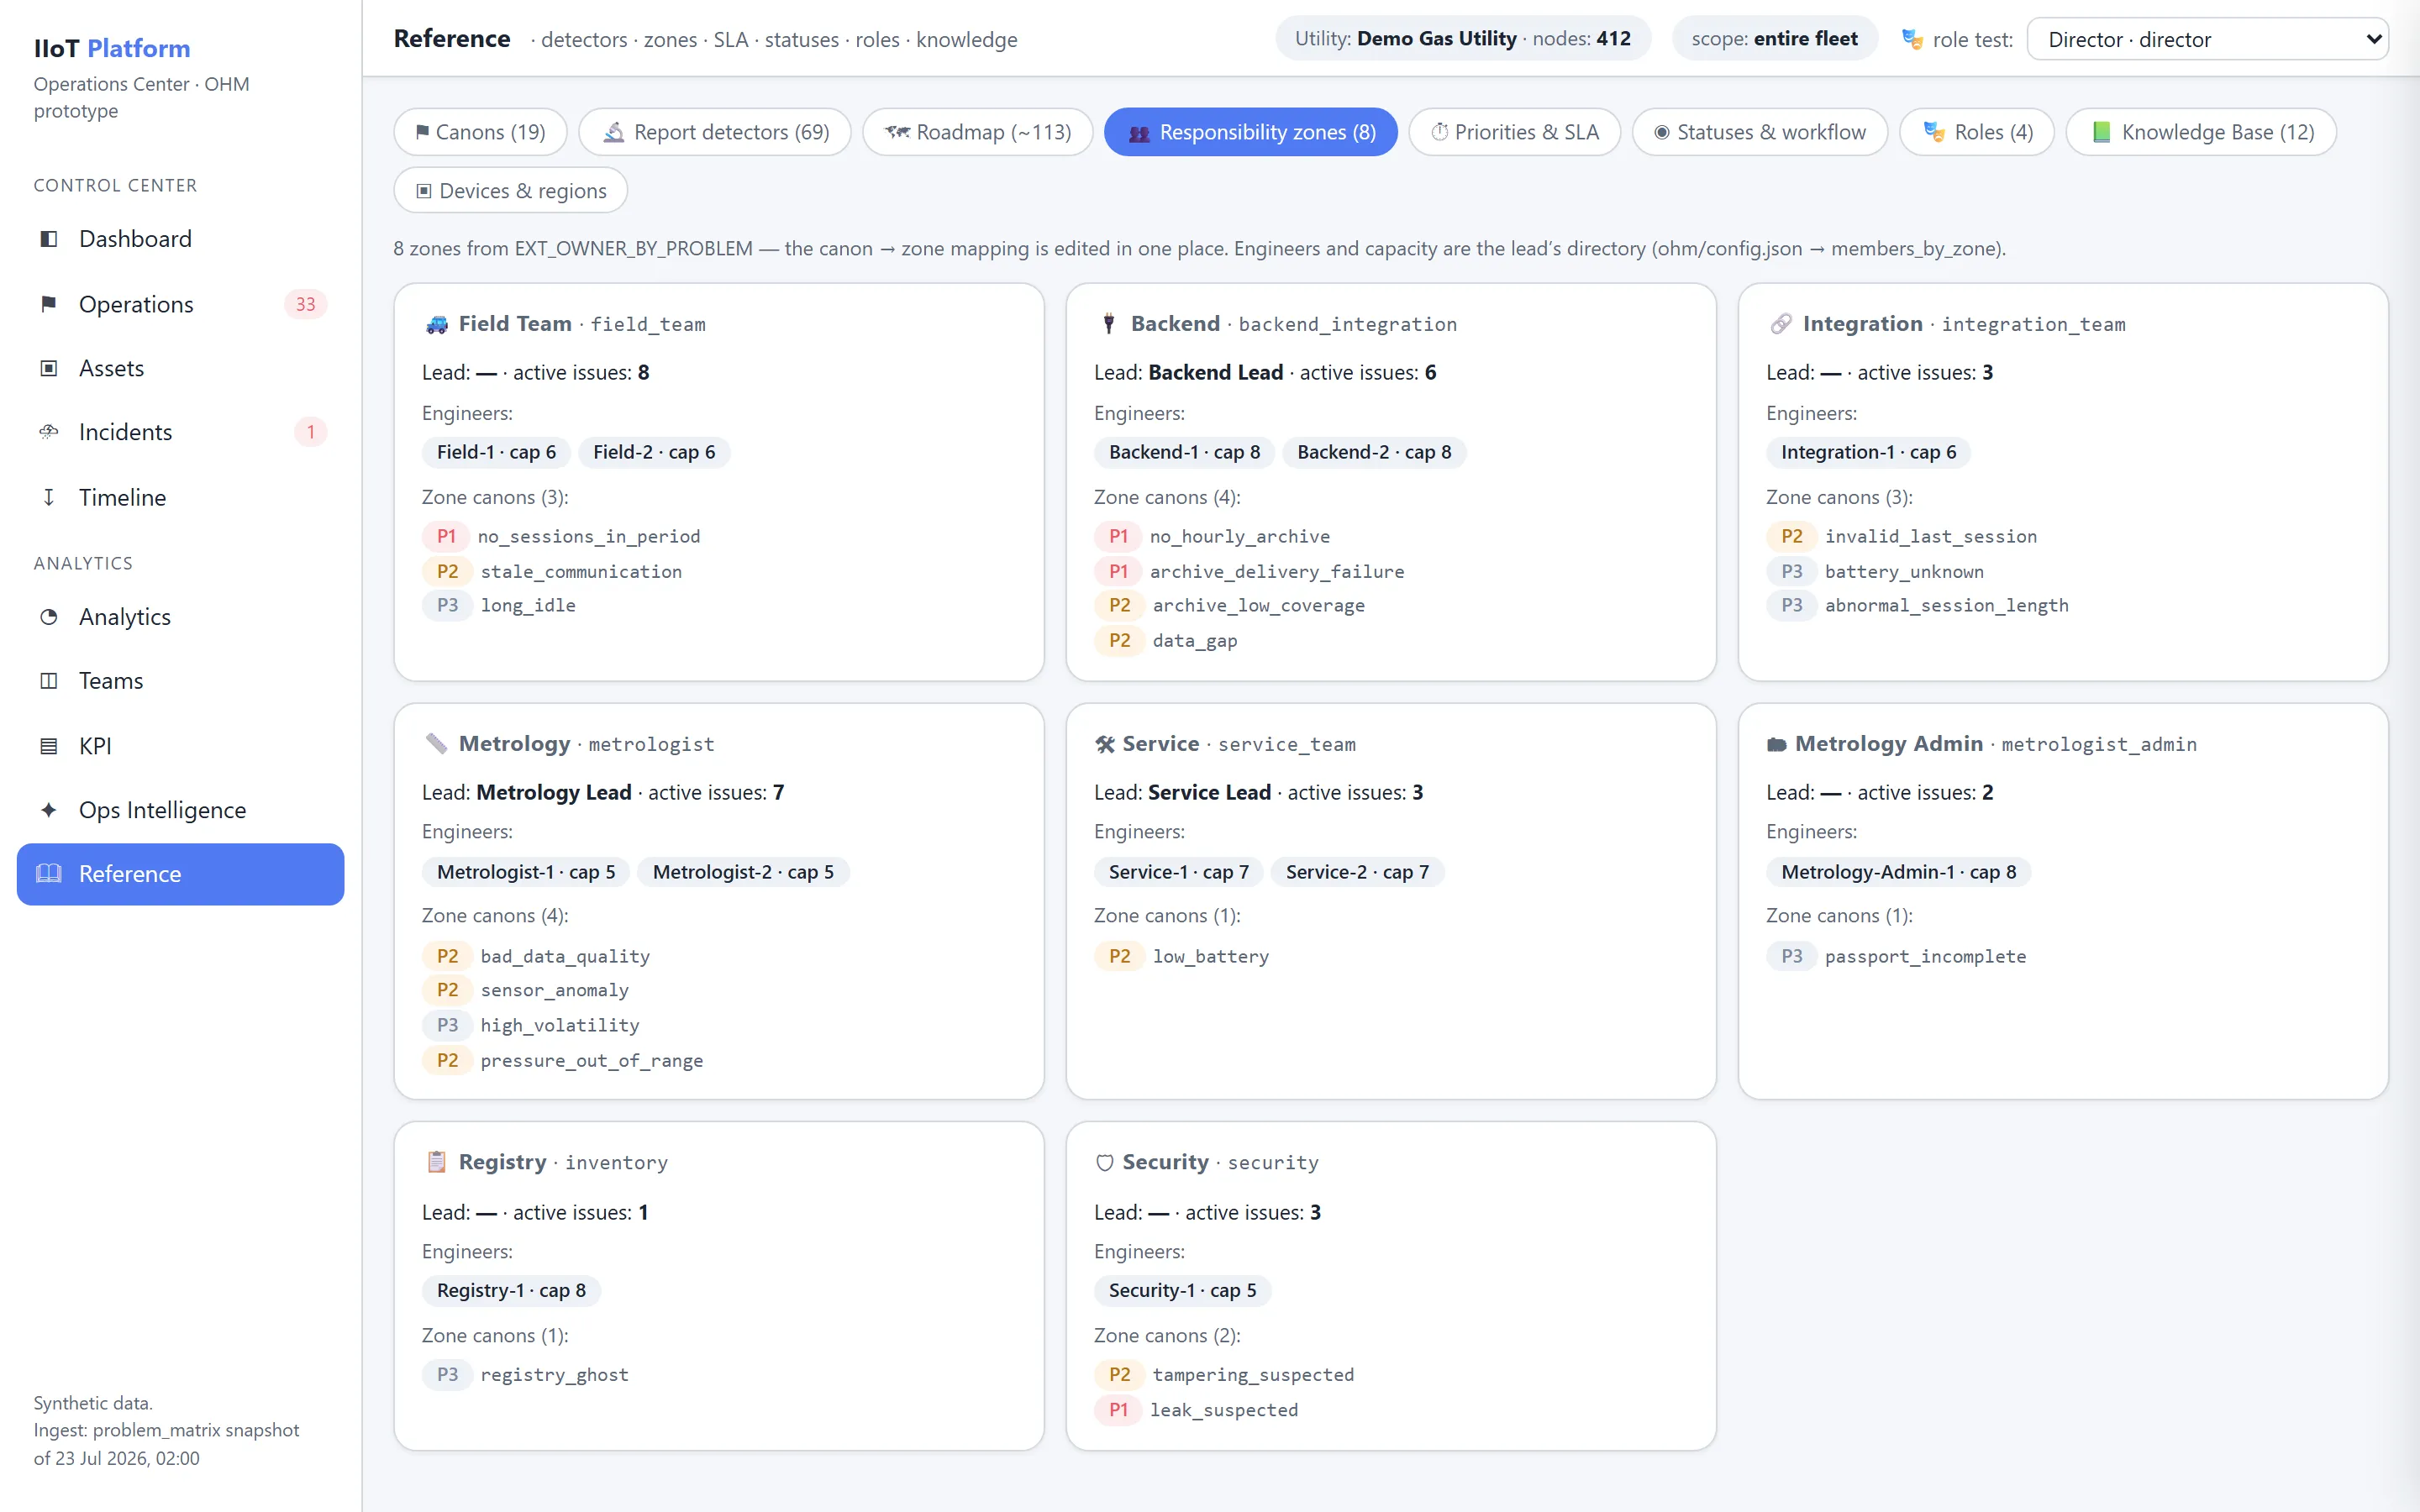
- încărcarea executanților;
- capacitatea;
- eficacitatea rezolvării;
- problemele cronice;
- cauzele fundamentale tipice.
Executant
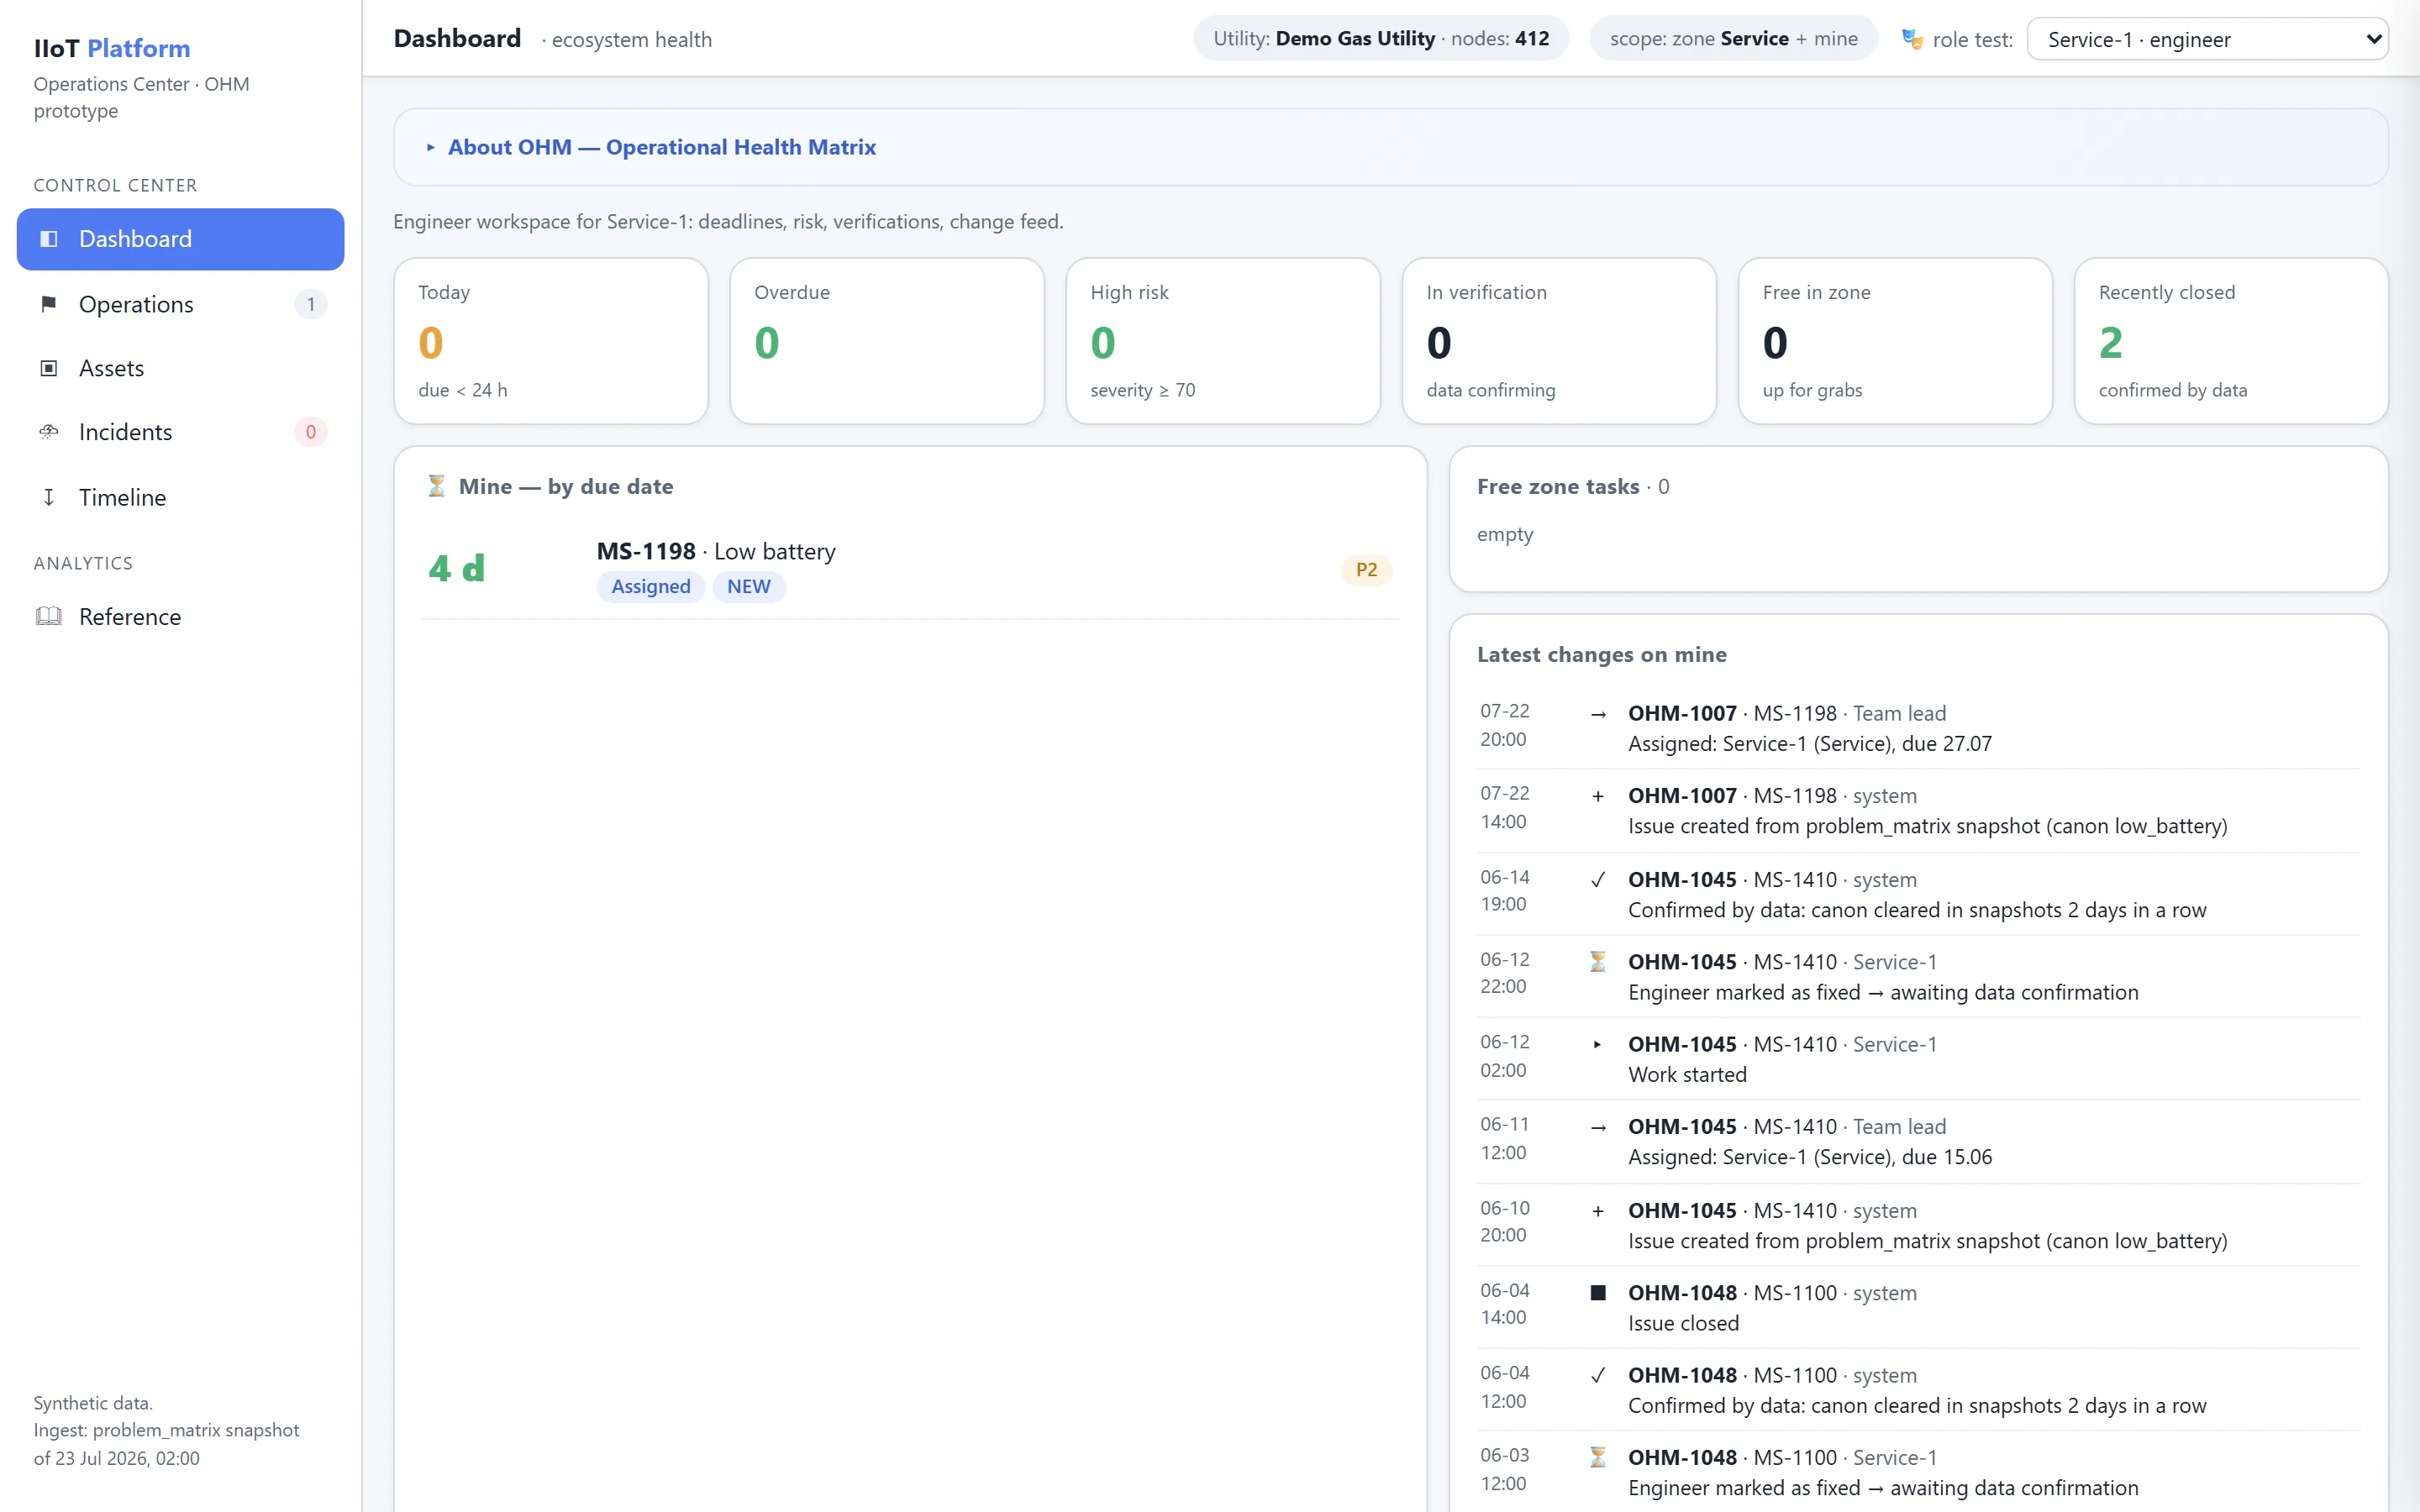
Vede:
- propriile sarcini (Tasks) active;
- termenul și
Due in(„termenul expiră peste”); - sarcinile cu termen depășit;
- sarcinile cu risc ridicat;
- sarcinile în așteptarea verificării;
- comentariile;
- modificările recente;
- articolele recomandate din baza de cunoștințe (KB);
- cazurile similare închise cu succes.
Metrolog
Vede în plus:
- problemele legate de cartea tehnică;
- coerența fizică a datelor;
- anomaliile senzorilor;
- verificarea acțiunilor metrologice;
- dovezile (Evidence) din rapoartele specializate;
- istoricul înlocuirilor și al etalonărilor.
Rolul de securitate
Vede numai contextul permis:
- semnalele de integritate;
- acțiunile anormale;
- modificările de configurație;
- incidentele de securitate confirmate;
- jurnalul de acces;
- lanțul de dovezi.
Accesul la datele sensibile și la dovezile de expertiză este restricționat prin politicile de acces.
Ecrane principale
Tablou de bord (Dashboard)
Tabloul de bord afișează starea ecosistemului și contextul operațional:
- scorul general de stare (Overall Health Score);
- starea comunicației (Communication Health);
- starea arhivelor (Archive Health);
- starea activelor (Asset Health);
- starea presiunii (Pressure Health);
- starea securității (Security Health);
- problemele critice (Critical Issues);
- problemele noi de astăzi (New Today);
- problemele cu termen depășit (Overdue);
- incidentele masive (Massive Incidents);
- încălcările termenului SLA (SLA Violations);
- distribuția cauzelor fundamentale (Root Cause Distribution);
- harta regiunilor;
- evoluția în timp;
- fluxul activităților operaționale (Operations Feed).
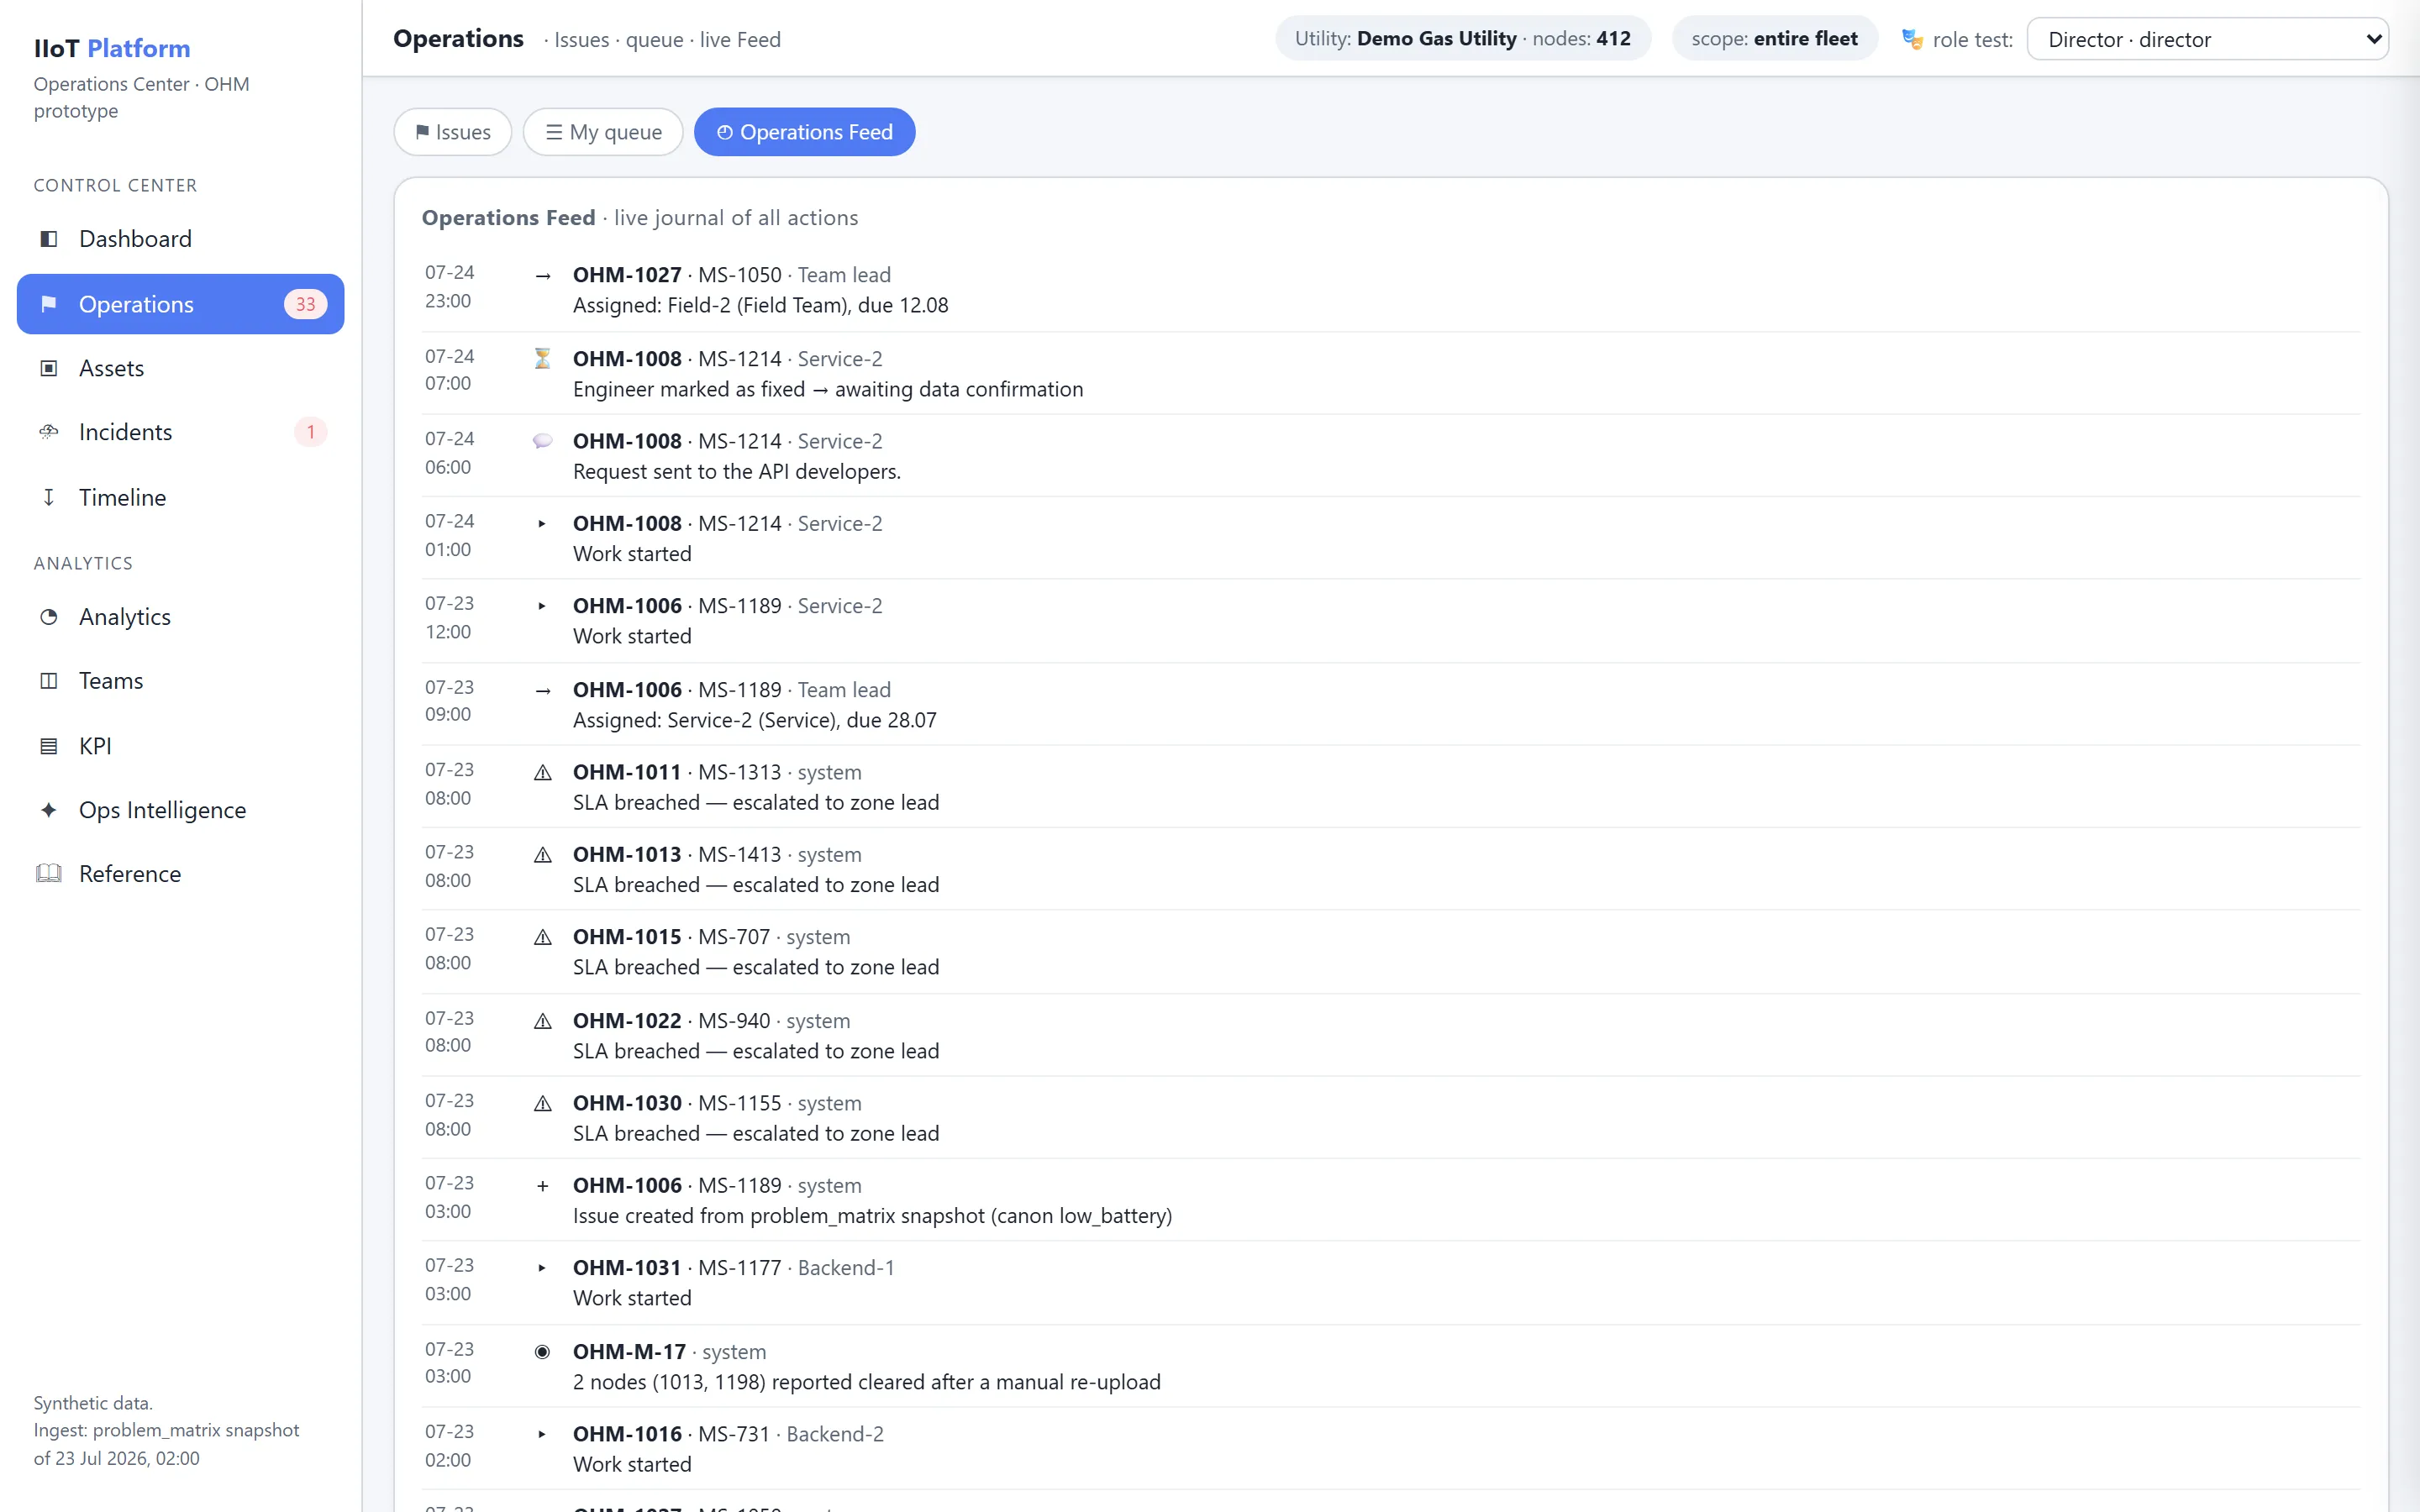
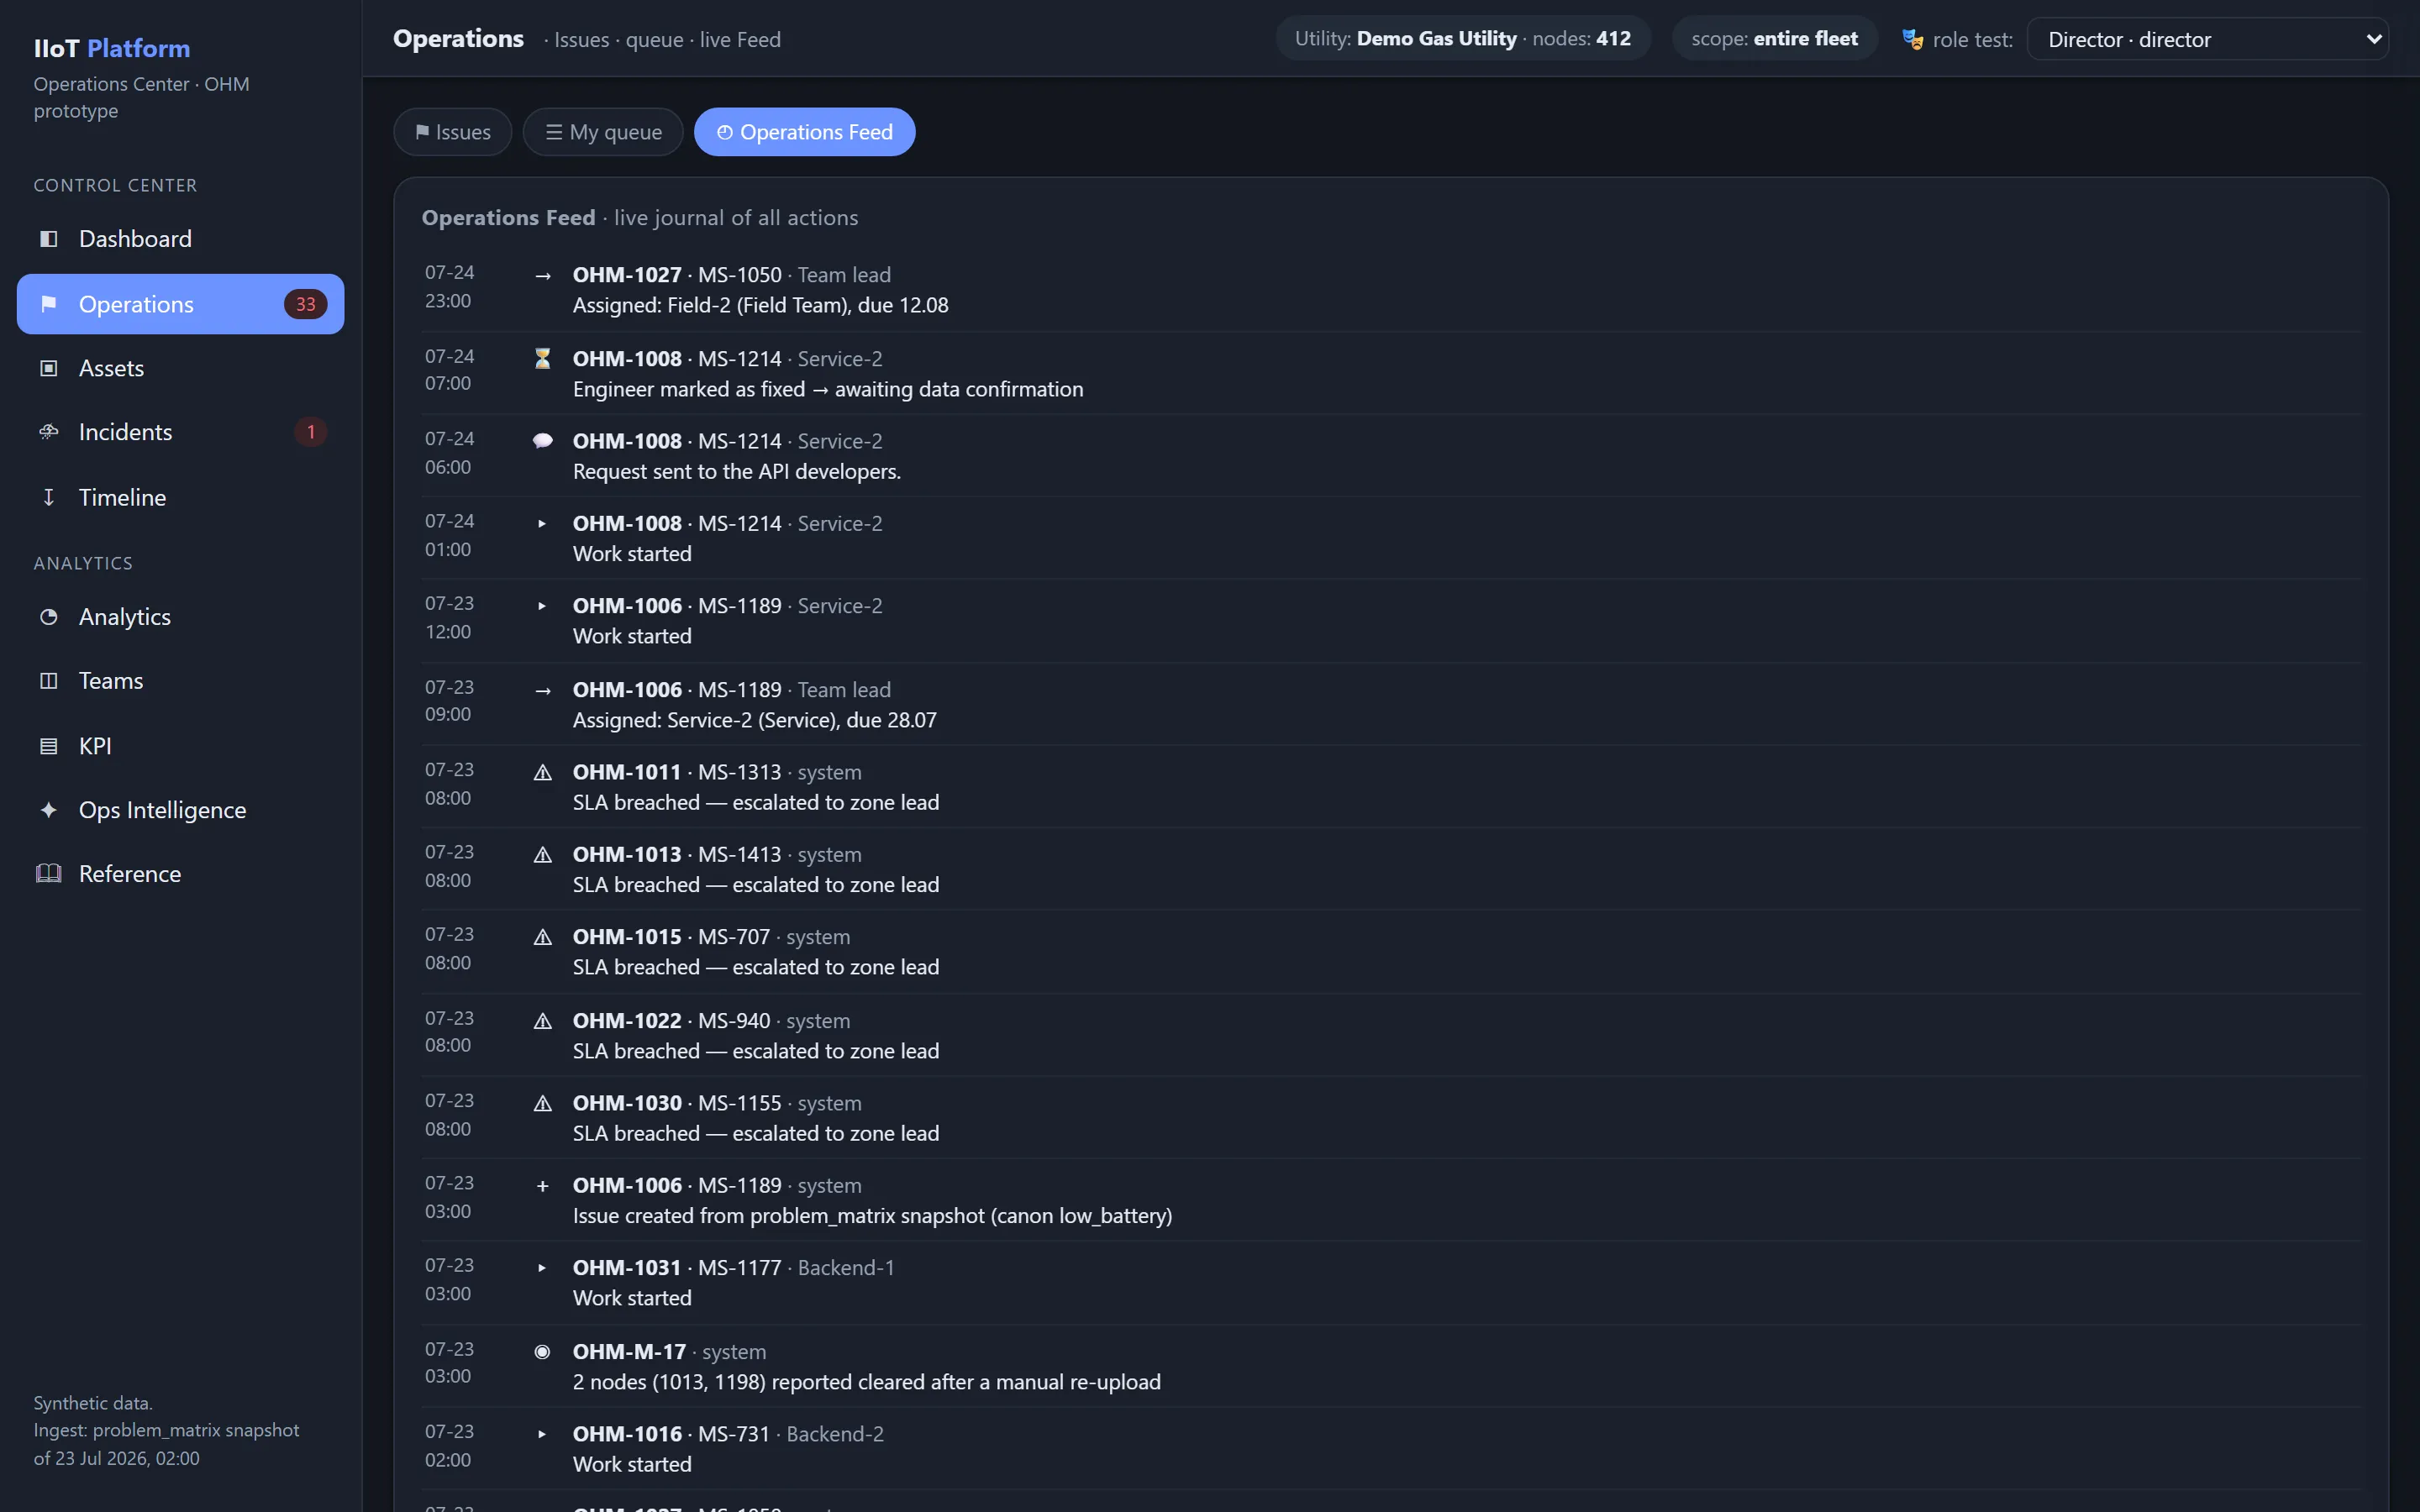
Activitate operațională (Operations)
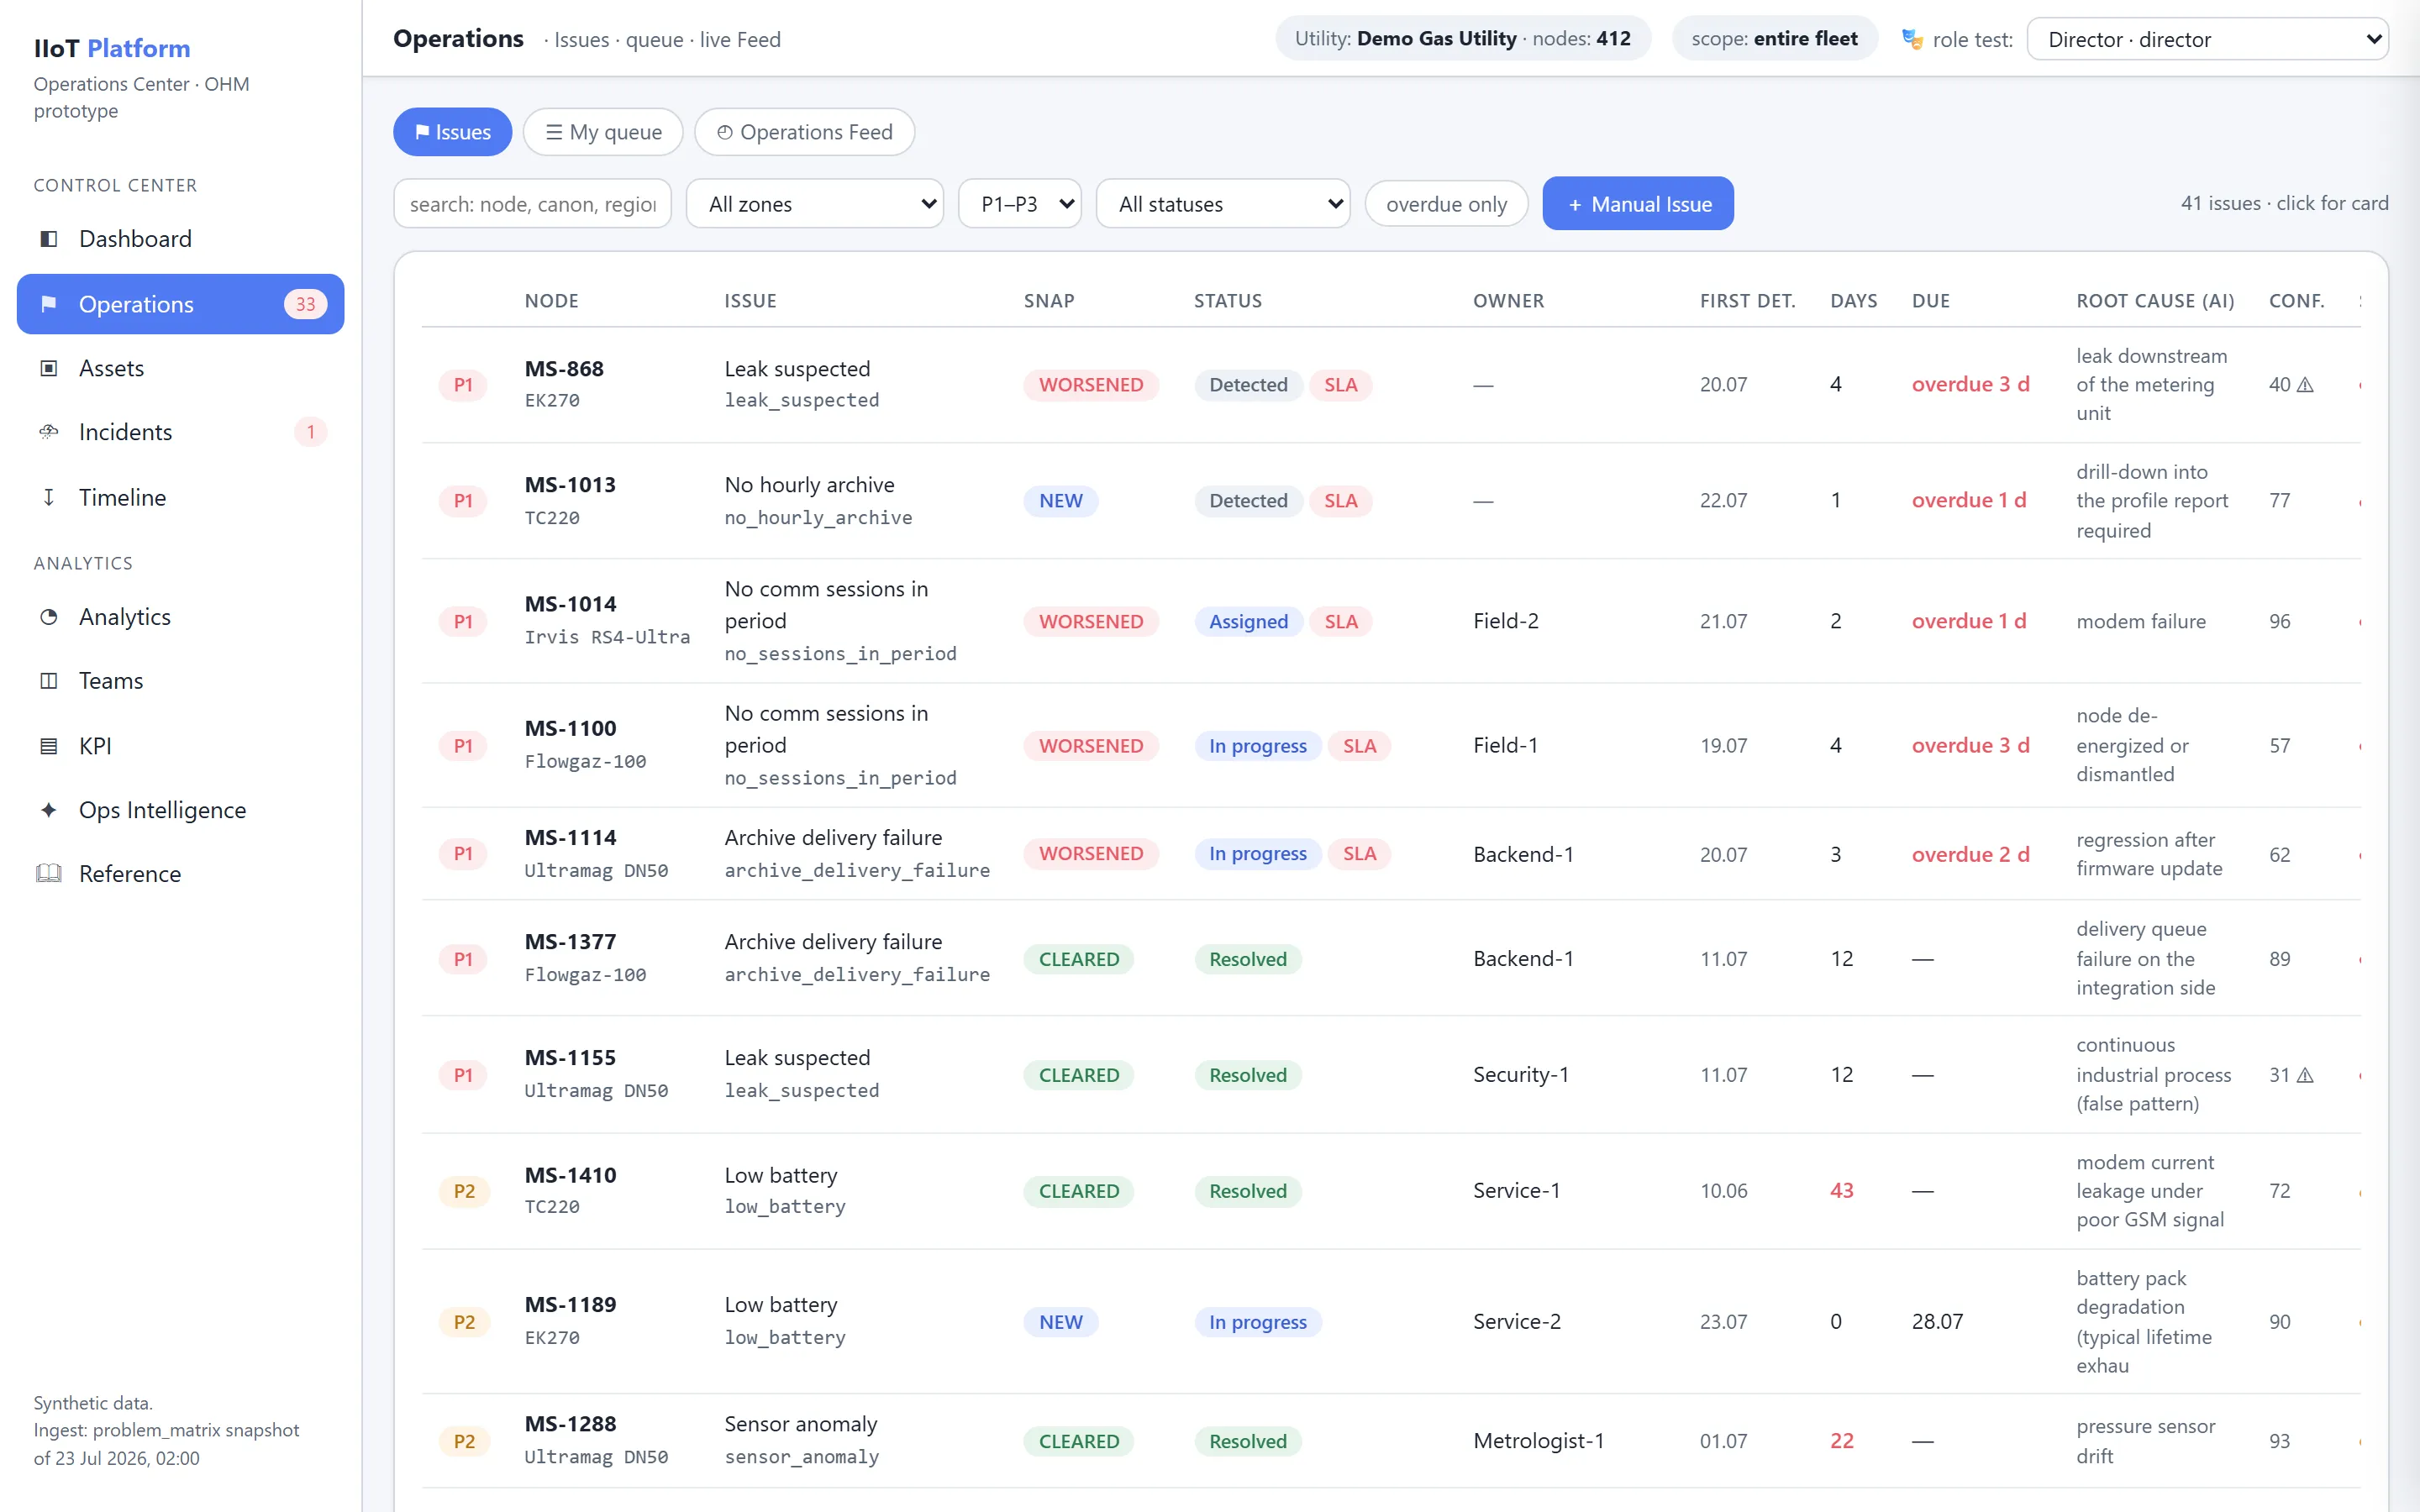
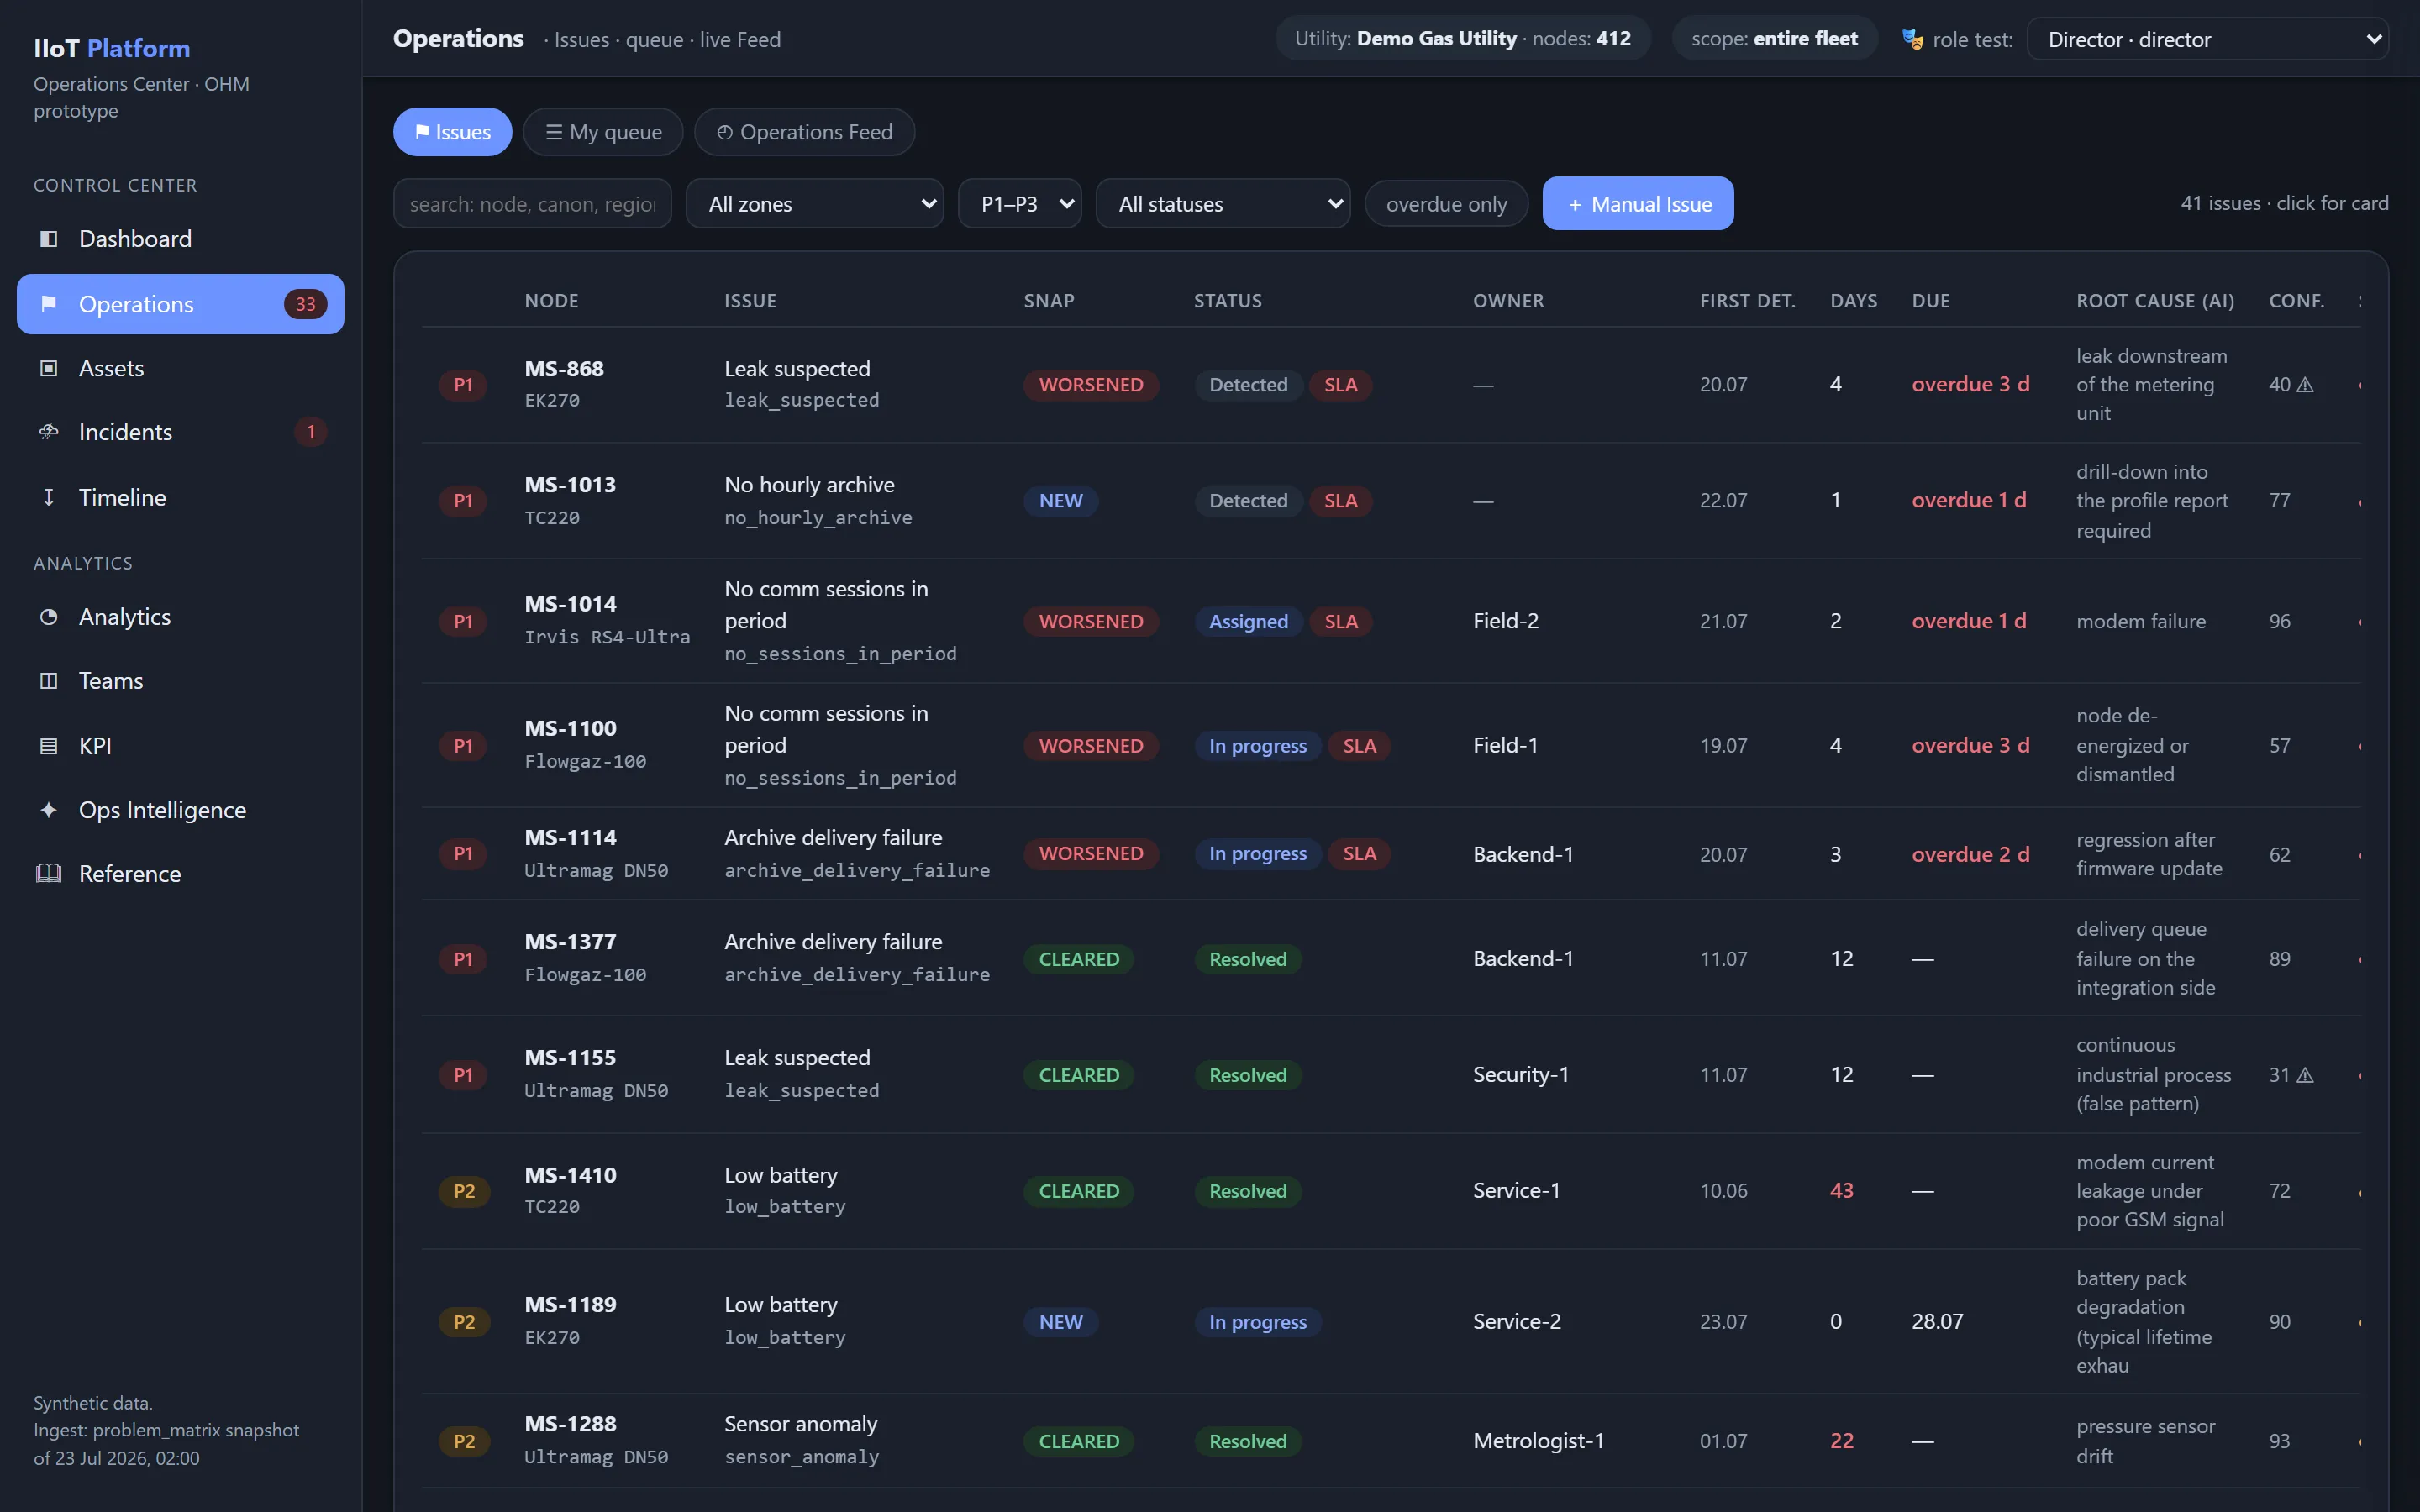
Lista principală de probleme conține:
- ID;
- prioritatea;
- statusul instantaneului (Snapshot);
- statusul fluxului de lucru;
- problema canonică (Canon);
- activul (Asset);
- regiunea;
- cauza fundamentală;
- nivelul de încredere;
- prima detectare;
- vechimea;
- executantul;
- termenul;
- SLA;
- numărul de redeschideri;
- identificatorul incidentului masiv;
- dependențele blocante.
Fișa problemei (Issue Card)
Fișa problemei reunește:
- datele de bază ale problemei;
- activele afectate;
- dovezile;
- fluxul de lucru;
- cauza fundamentală;
- impactul;
- sarcinile;
- comentariile;
- cronologia;
- problemele asociate;
- dependențele;
- articolele din baza de cunoștințe;
- acțiunile;
- rezultatul verificării;
- pista de audit (Audit Trail).
Fișa completă a problemei și ciclul ei de viață sunt descrise pe pagina Problemele operaționale și ciclul lor de viață.
Active (Assets)
Fișa activului afișează:
- identificatorii;
- tipul și modelul;
- regiunea;
- configurația;
- firmware-ul;
- starea telemetriei;
- scorul de stare (Health Score);
- scorurile parțiale;
- problemele active;
- istoricul;
- problemele recurente;
- activele asociate;
- lucrările finalizate;
- documentele.
Modelul stării pe care se bazează aceste scoruri este descris pe pagina Starea activelor și a ecosistemului.
Incidente masive (Massive Incidents)
Ecranul incidentelor masive afișează:
- amploarea;
- intervalul de timp;
- semnătura comună;
- activele afectate;
- versiunile și dependențele comune;
- cauza fundamentală suspectată;
- progresul restabilirii;
- problemele individuale rămase;
- analiza post-incident.
Corelarea incidentelor și ciclul lor de viață sunt descrise pe pagina Gestionarea incidentelor masive.
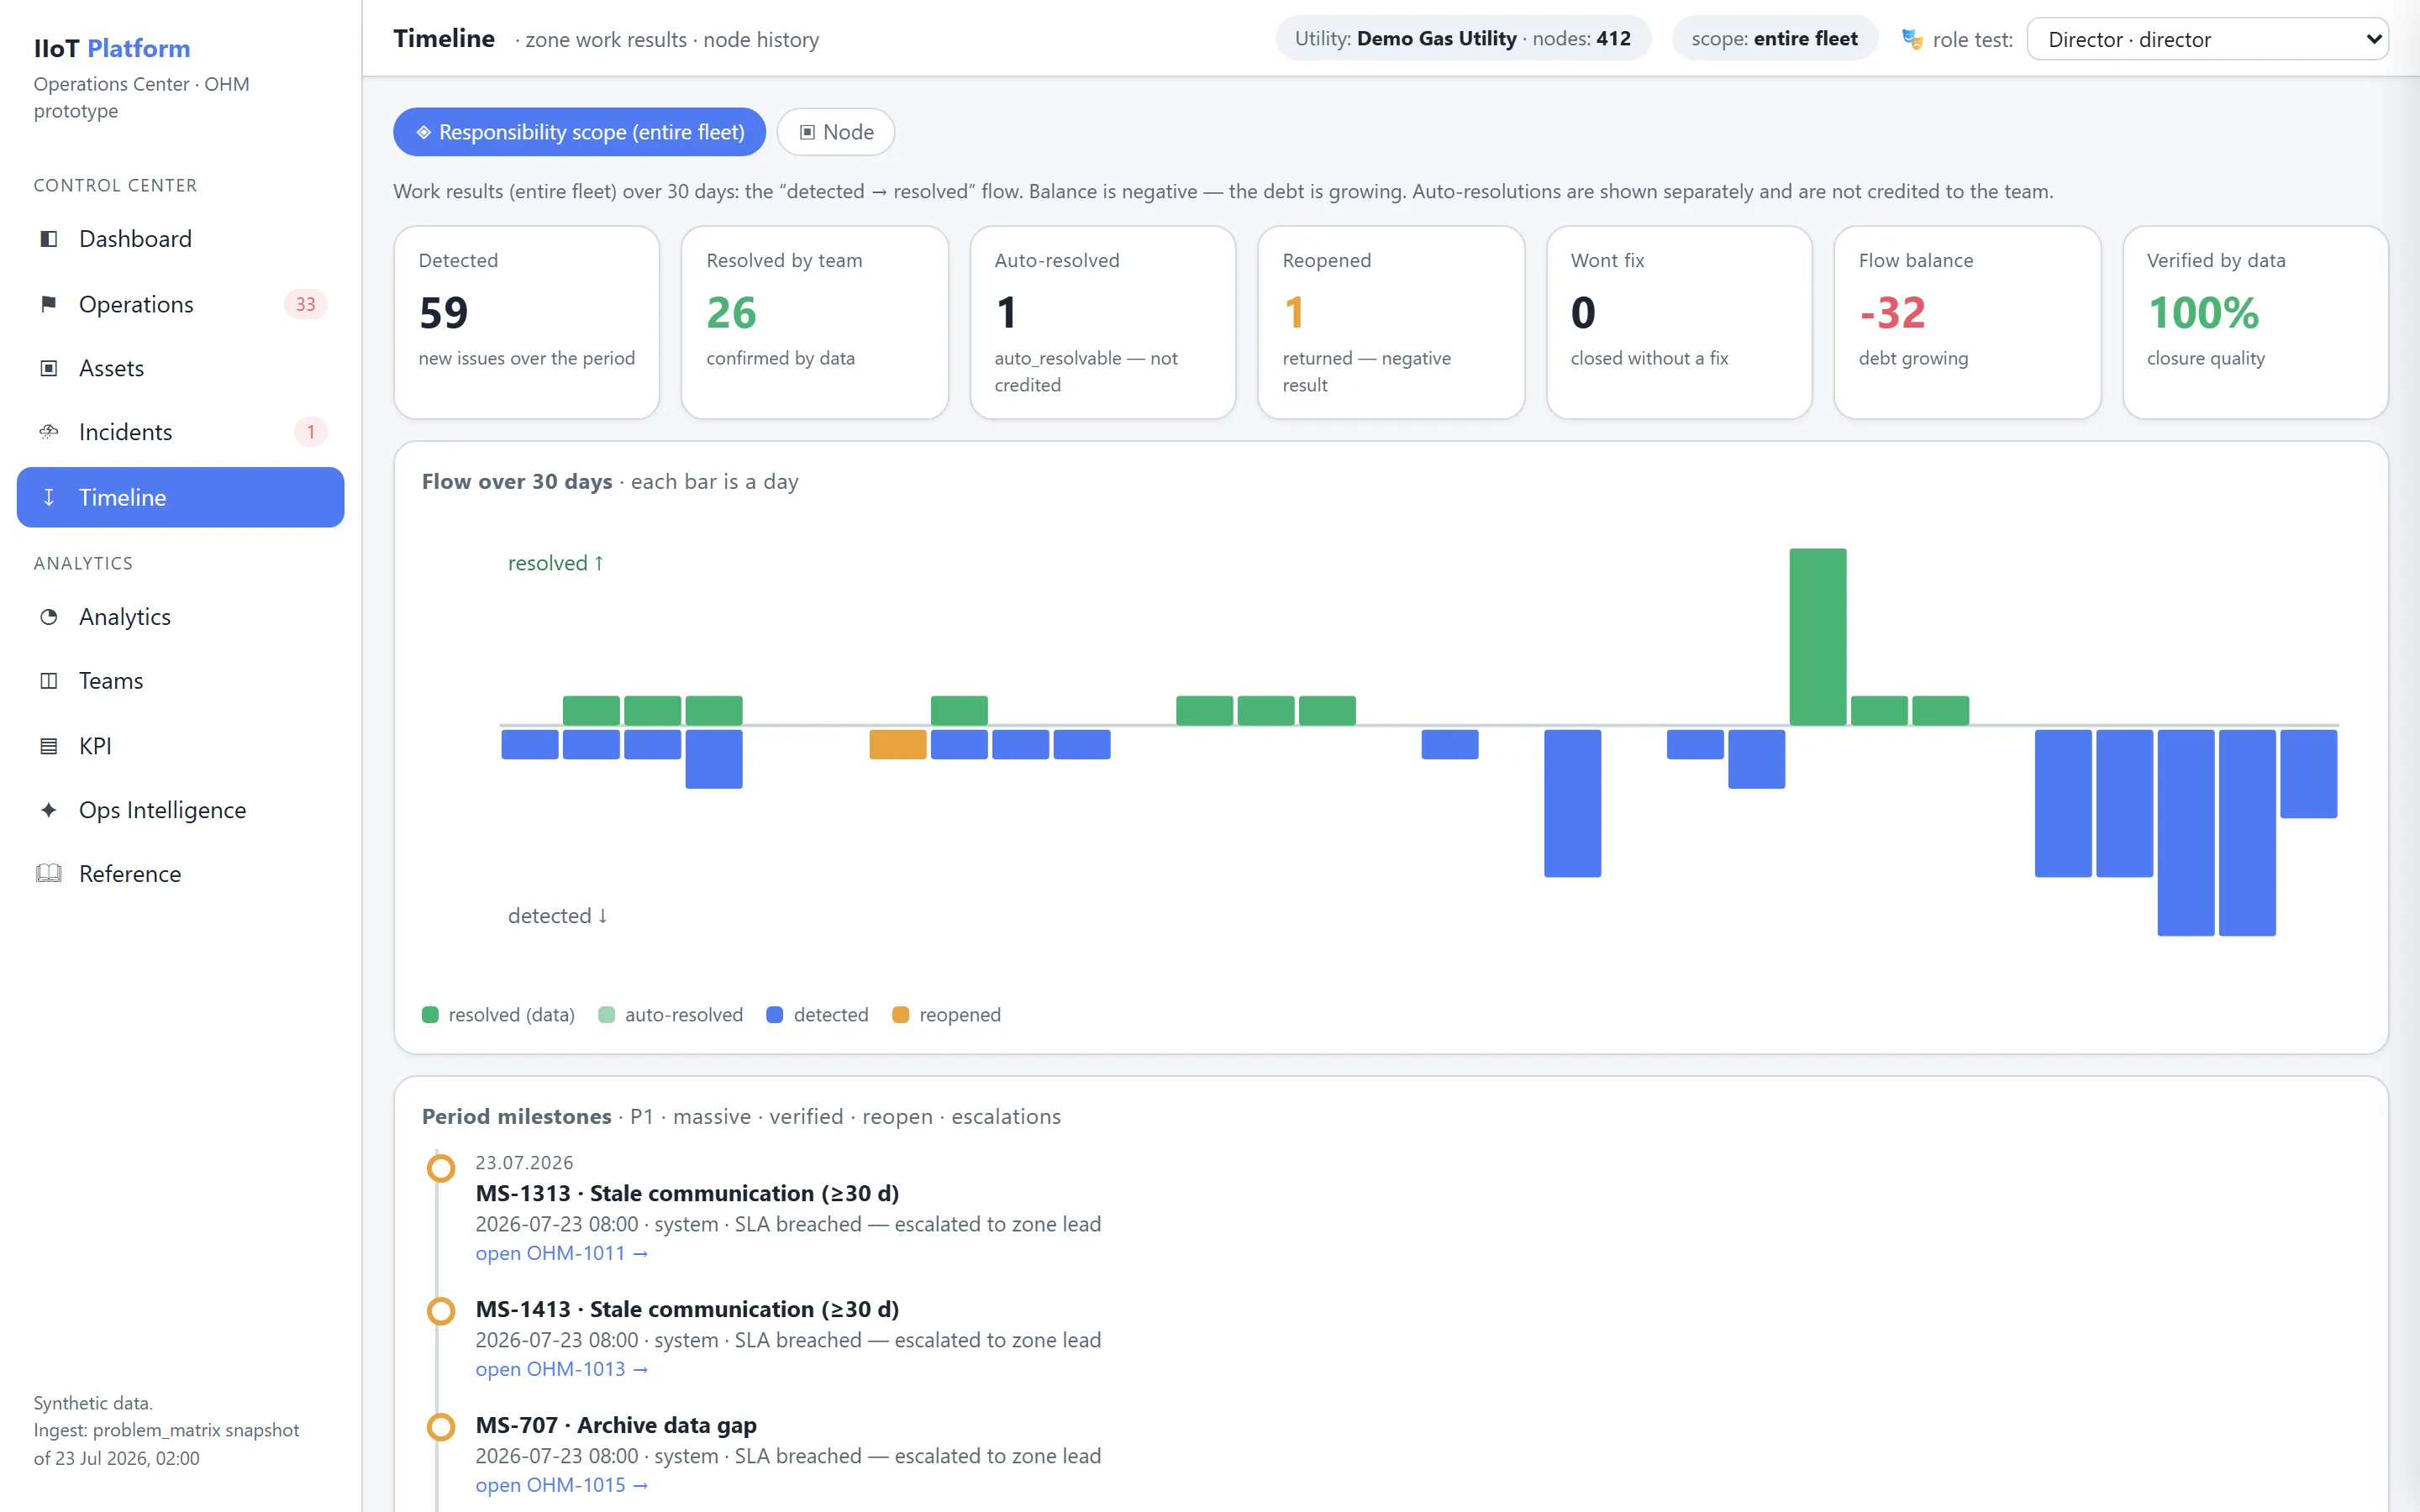
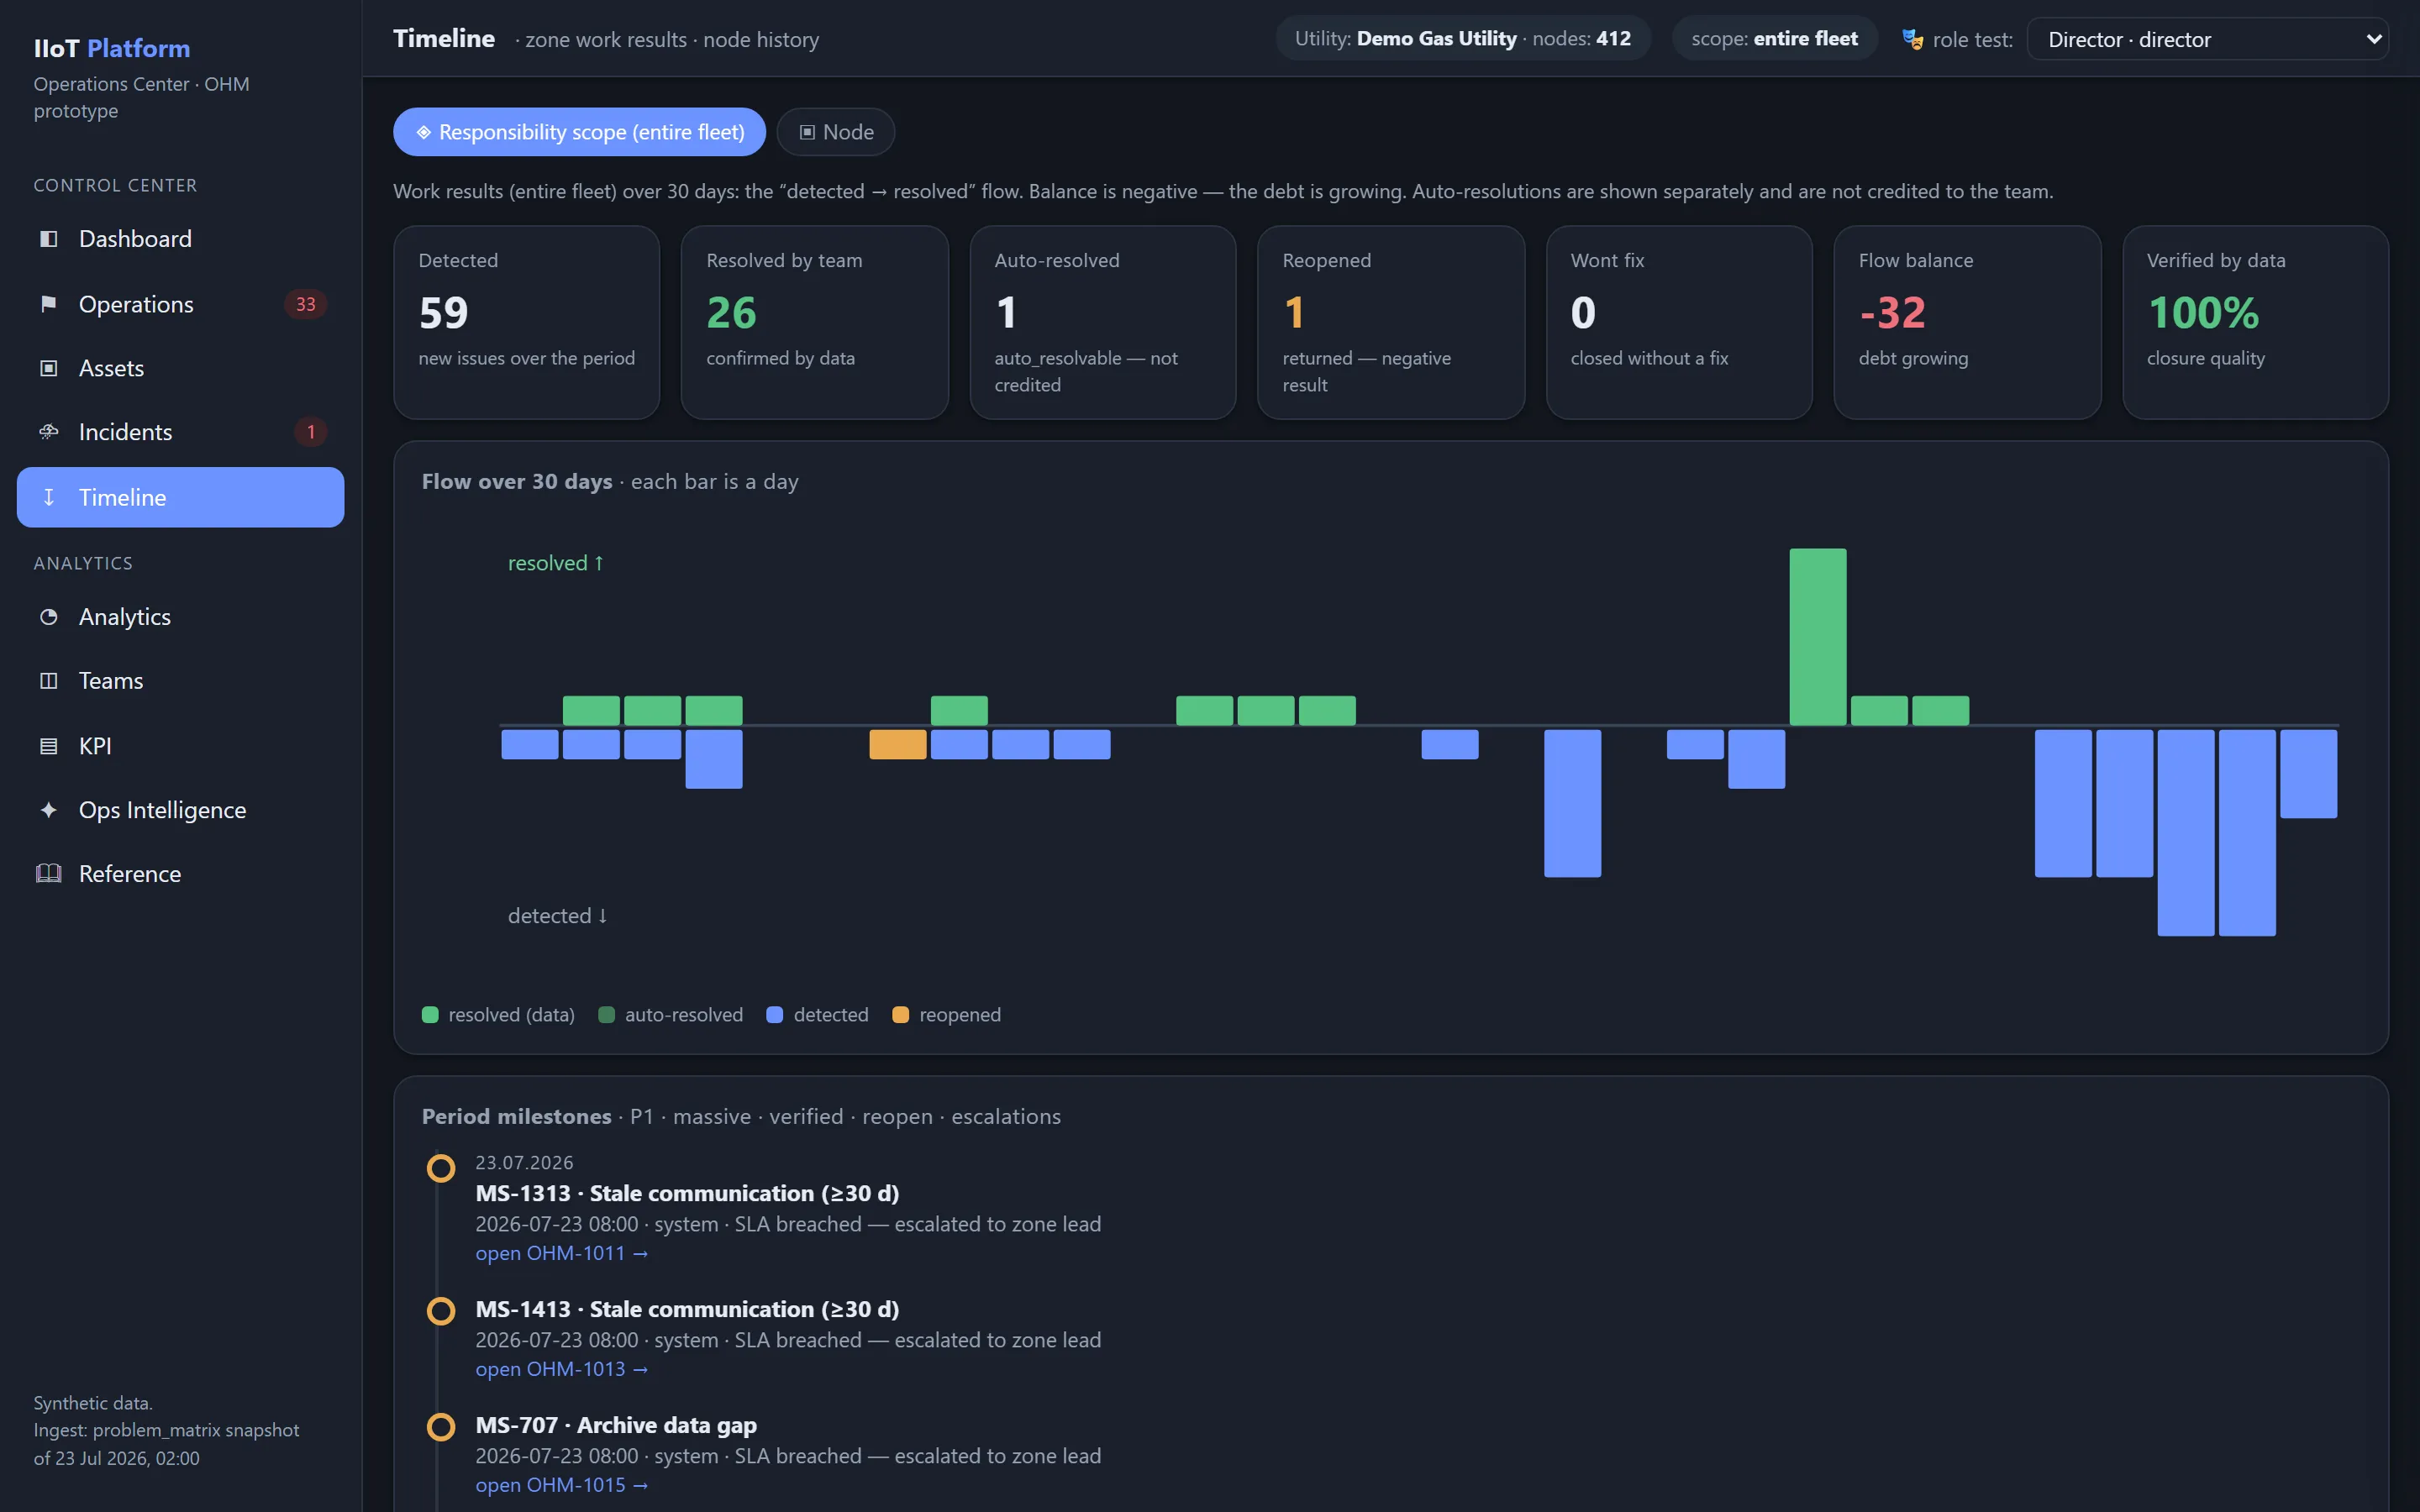
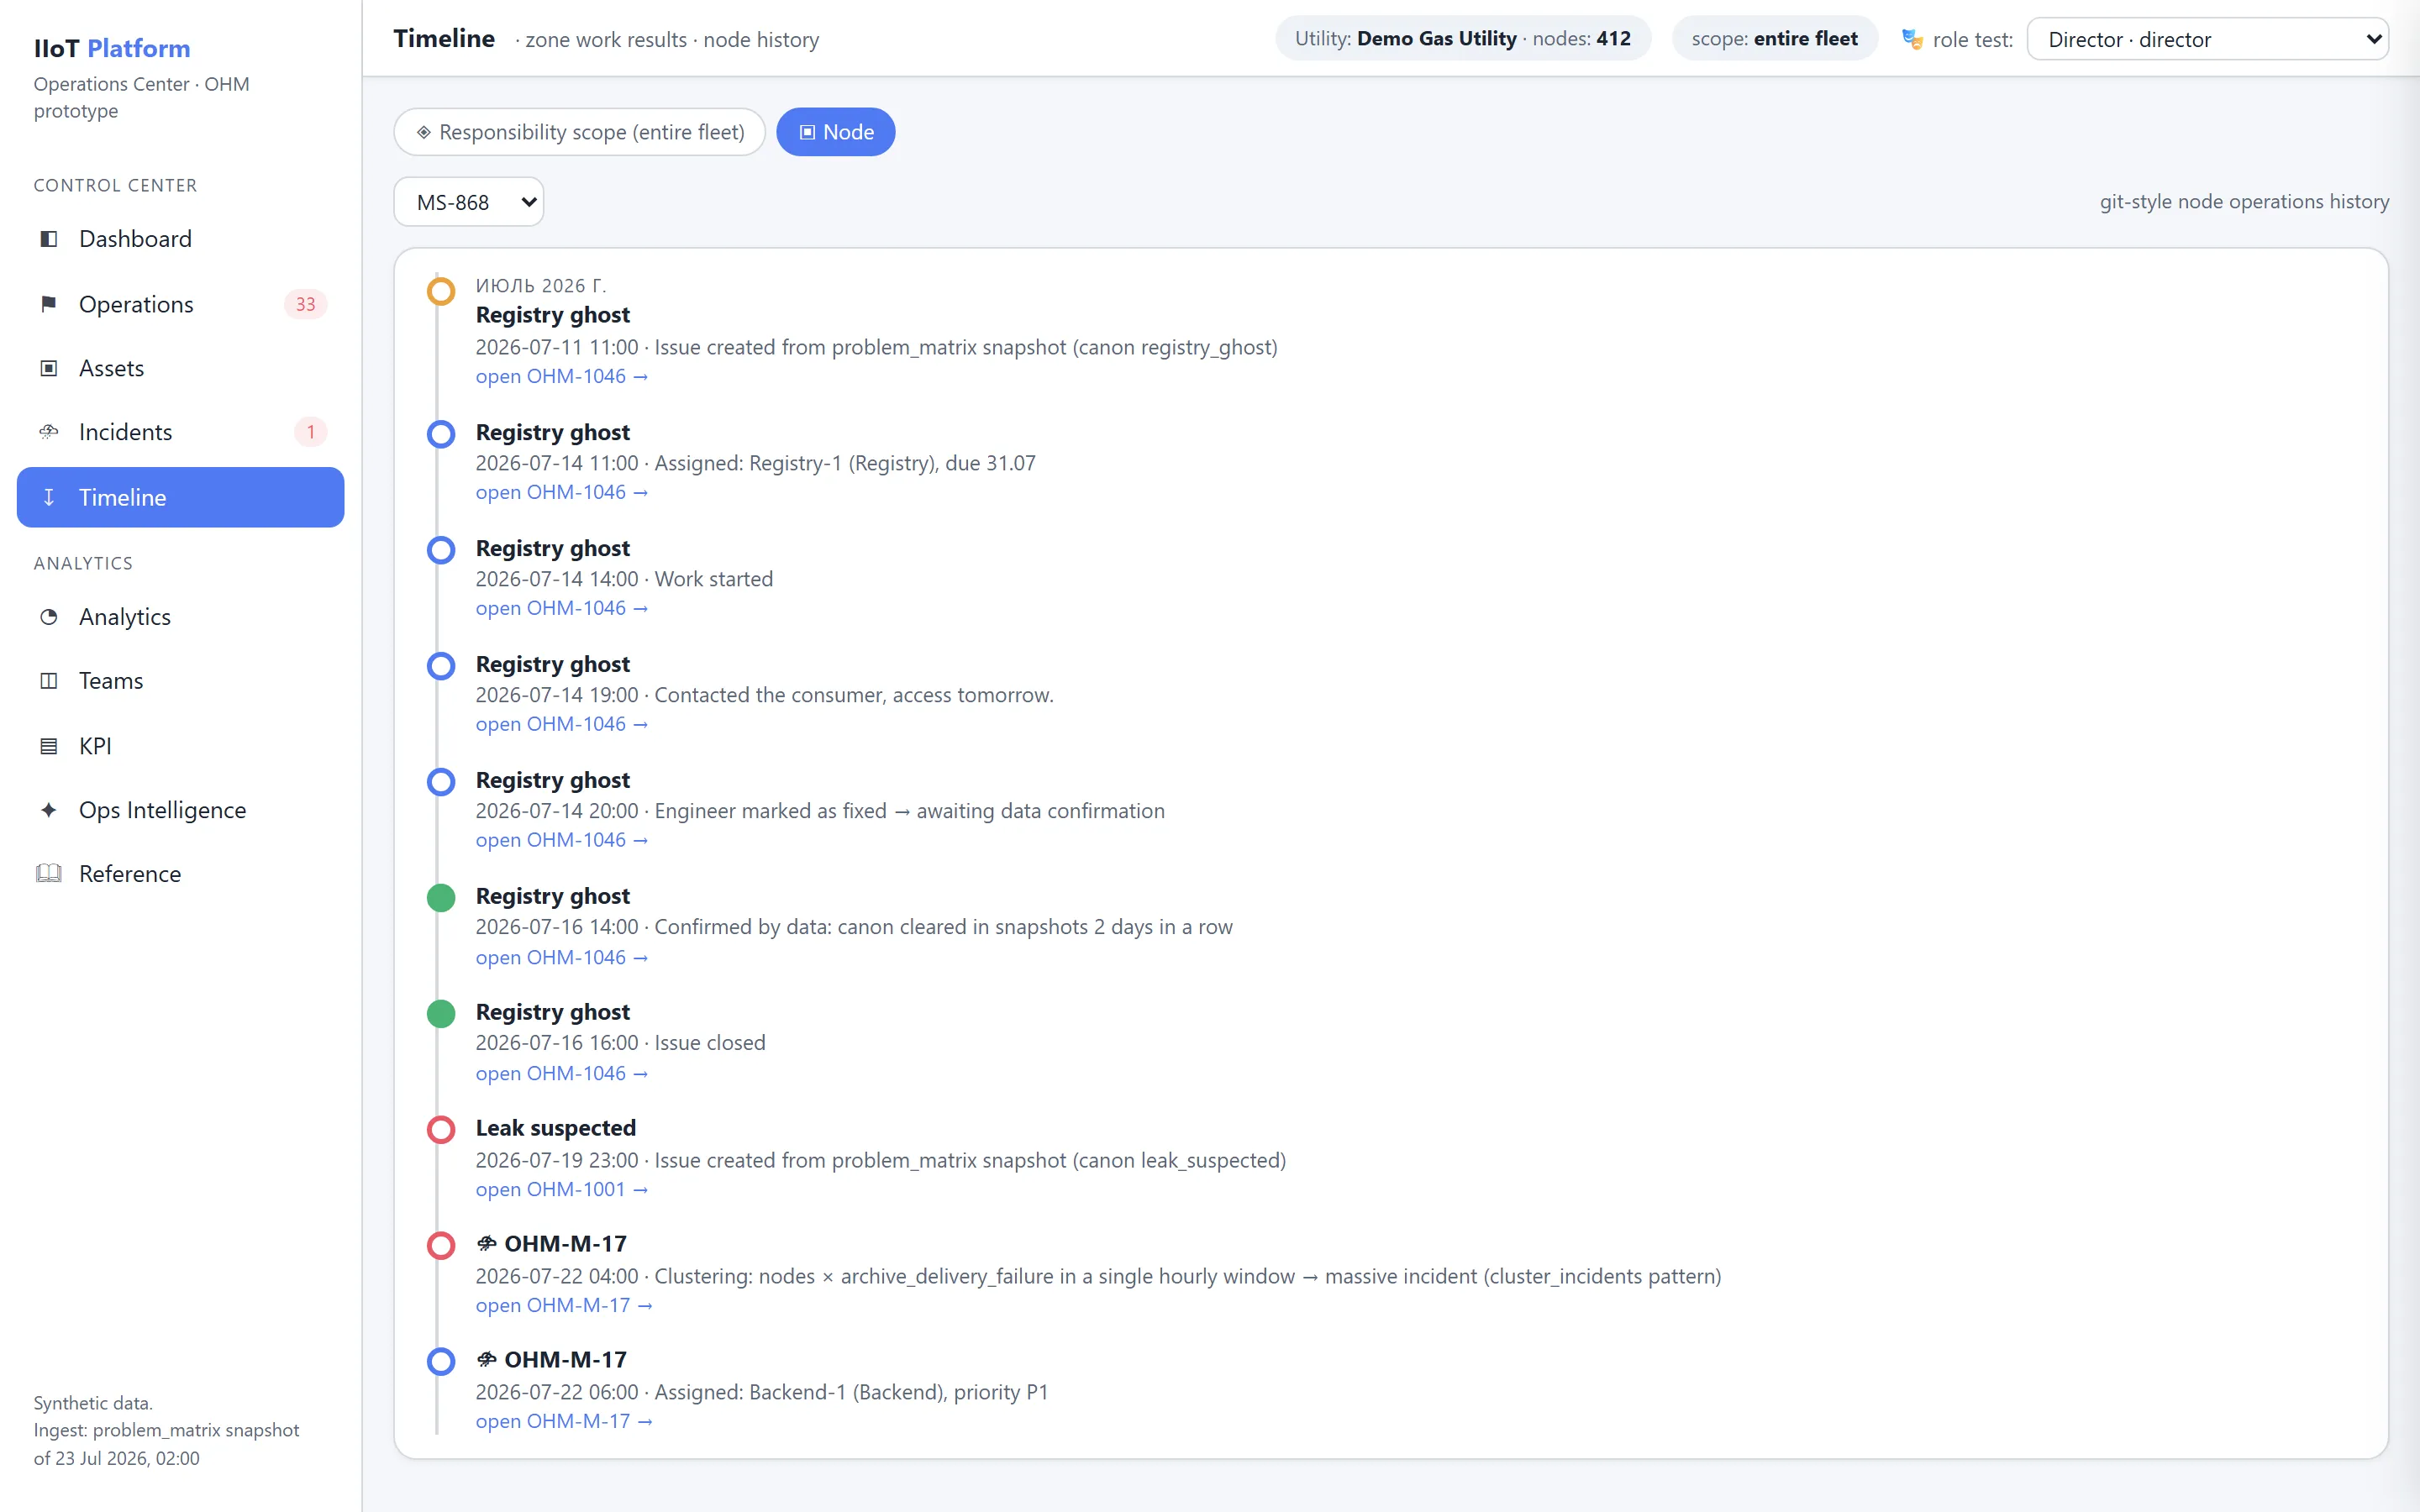
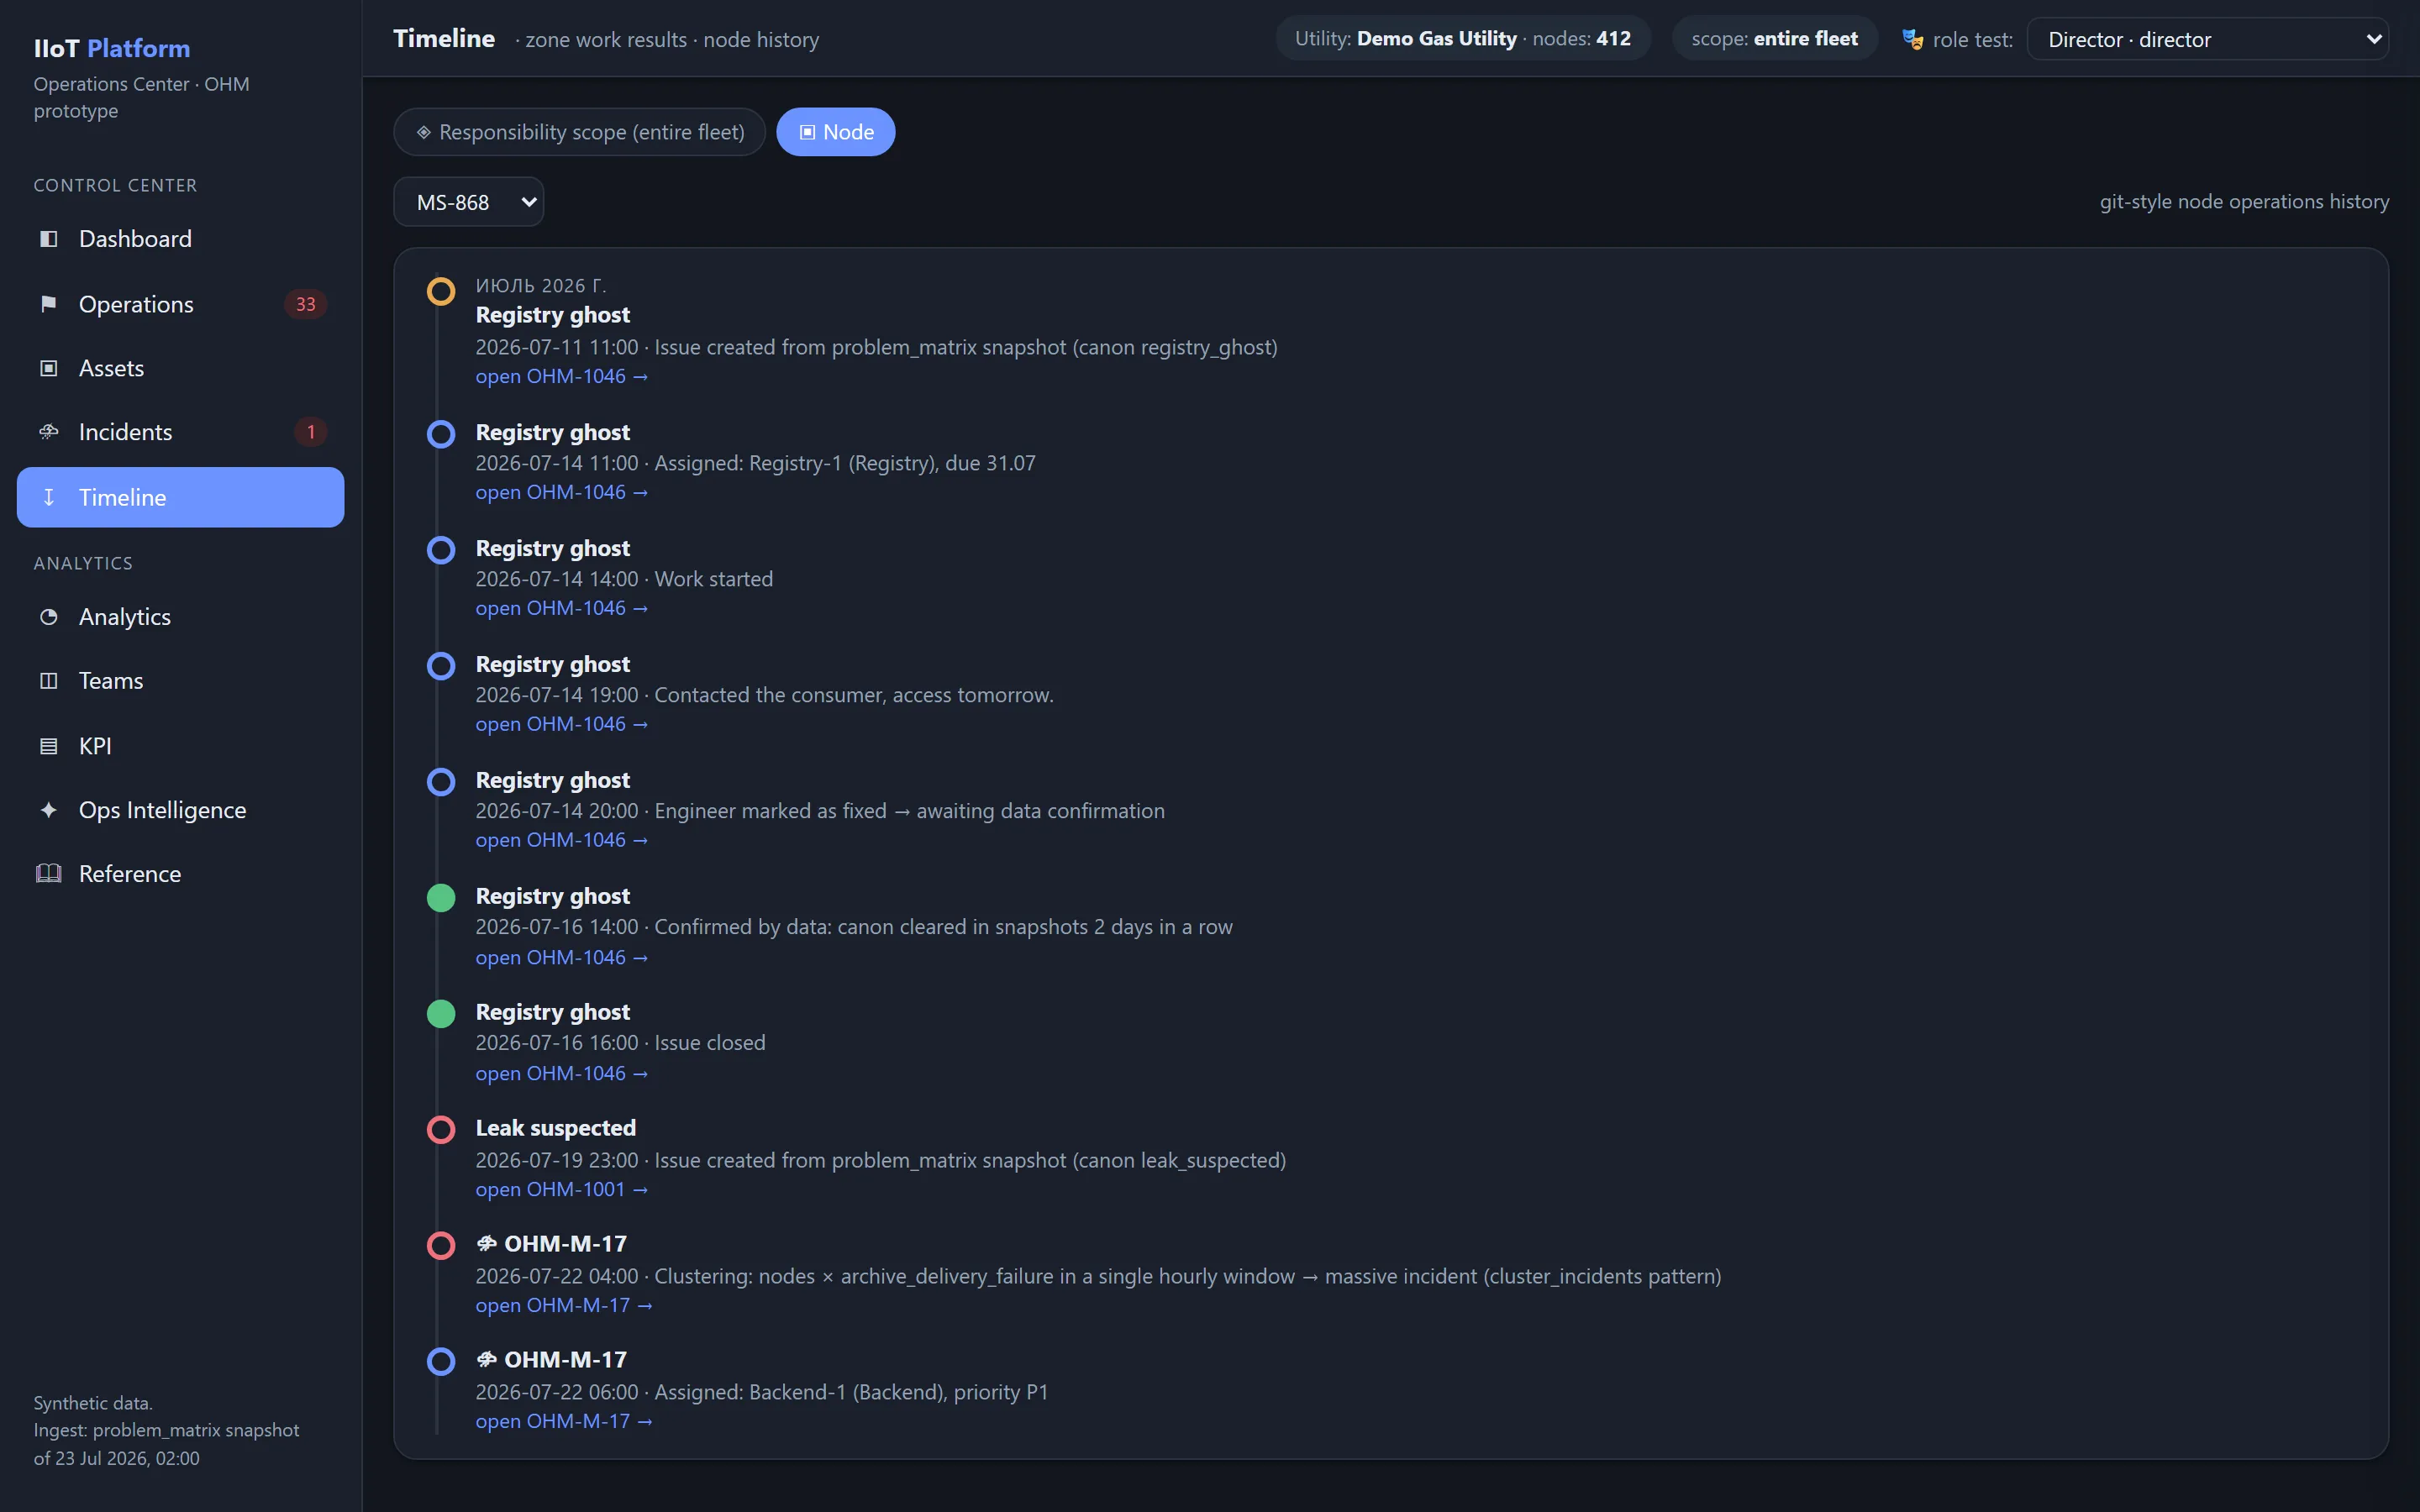
Cronologie (Timeline)
Cronologia este istoricul operațional unic:
| Ora | Eveniment |
|---|---|
| 09:14 | Problemă detectată |
| 09:16 | Dovadă atașată |
| 09:18 | Corelată cu OHM-2026-001811 |
| 09:23 | Atribuită echipei Integration-2 |
| 10:04 | Lucrări începute |
| 11:42 | Configurație corectată |
| 12:10 | În așteptarea verificării |
| 13:00 | Primul instantaneu fără problemă |
| A doua zi, 04:00 | Al doilea instantaneu fără problemă |
| 04:01 | Verificată pe baza datelor |
| 04:02 | Rezolvată |
Analize (Analytics)
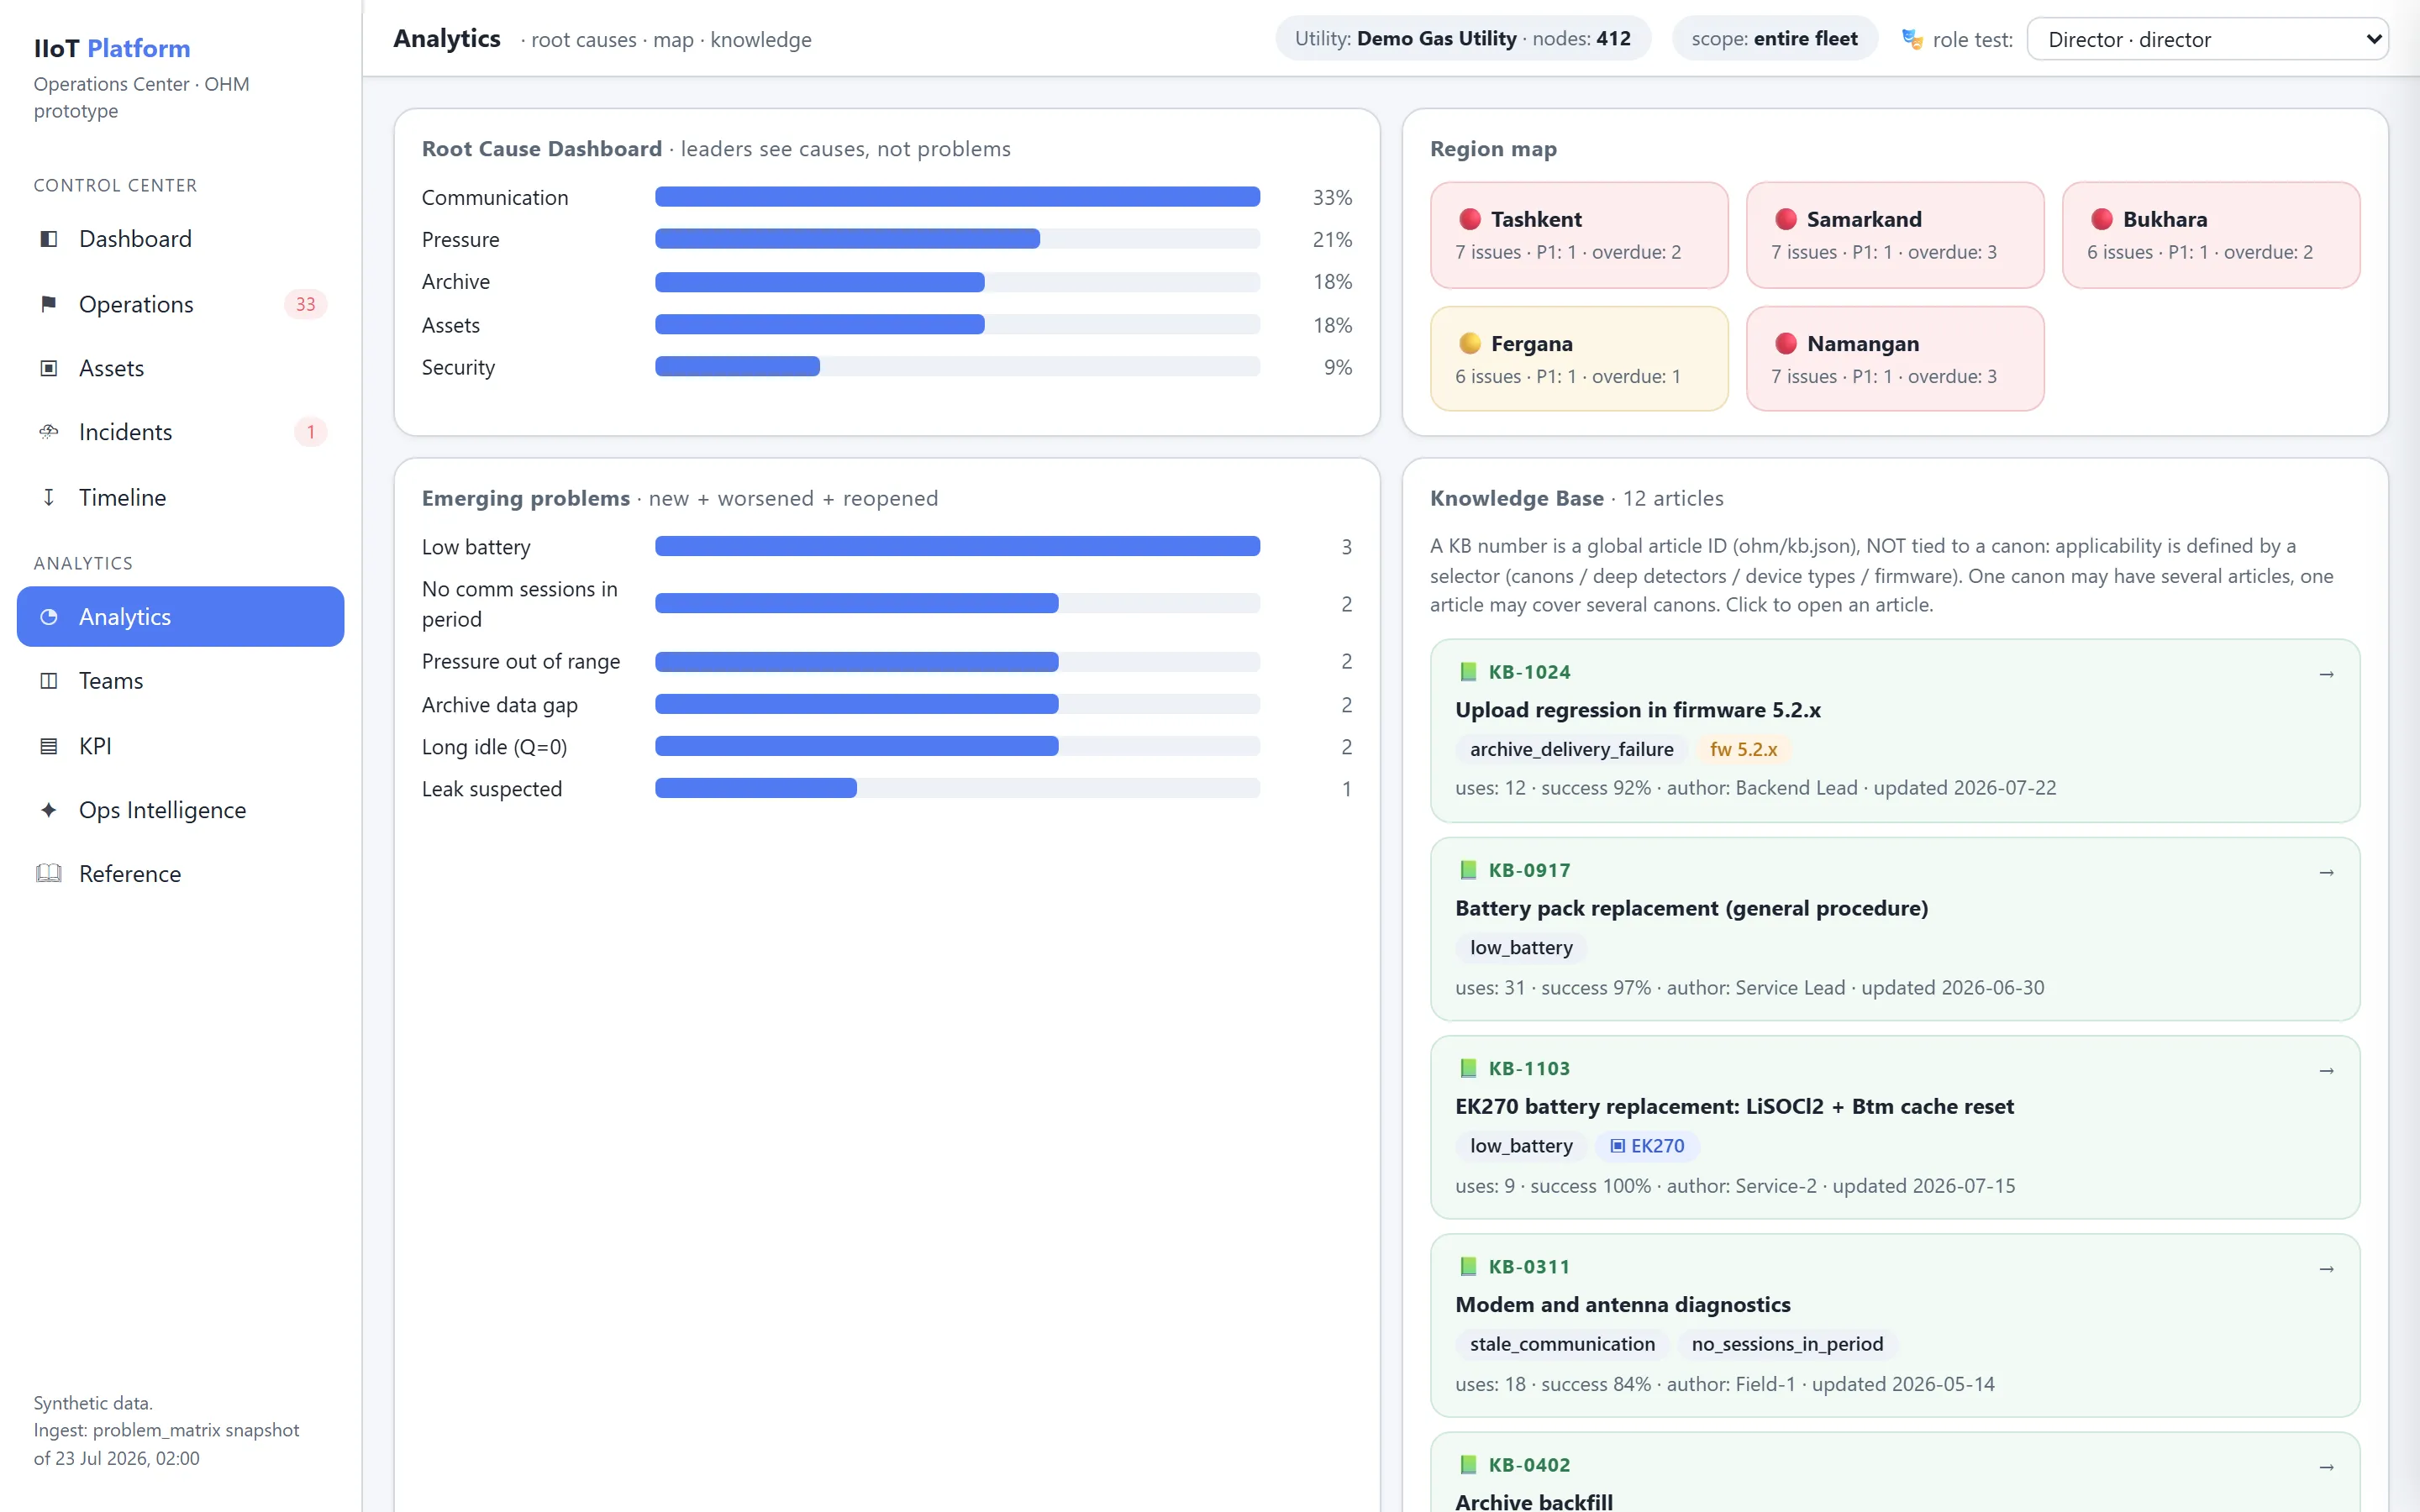
Ecranul Analize conține:
- tabloul de bord al cauzelor fundamentale (Root Cause Dashboard);
- distribuția problemelor;
- recurența;
- evoluția respectării termenelor SLA;
- calitatea detectoarelor;
- evoluția stării activelor;
- comparația între regiuni;
- impactul topologiei;
- eficacitatea bazei de cunoștințe;
- riscurile prognozate.
Echipe (Teams)
Ecranul Echipe afișează:
- capacitatea;
- încărcarea din problemele deschise;
- încărcarea din problemele cu termen depășit;
- încărcarea din problemele P1;
- încărcarea din verificări;
- gradul de utilizare;
- echilibrul repartizării sarcinilor;
- vechimea sarcinilor restante;
- prognoza încărcării.
Indicatorii pe care se bazează acest ecran sunt descriși pe pagina KPI operaționali și performanța echipelor.
Analiza operațională (Operations Intelligence)
Analiza operațională reunește:
- riscurile emergente;
- grupurile de anomalii;
- defecțiunile prognozate;
- cauzele fundamentale probabile;
- incidentele similare;
- recomandările;
- starea detectoarelor;
- nivelul de încredere al analizei cu IA;
- modificările neexplicate.
Modul în care se generează aceste recomandări este descris pe pagina Analiza operațională cu IA.
Perimetru și filtrare
Toate ecranele folosesc același perimetru (Scope).
Exemple:
- organizația;
- regiunea;
- districtul;
- zona de responsabilitate;
- executantul;
- tipul de activ;
- modelul de dispozitiv;
- firmware-ul;
- operatorul de telecomunicații;
- gateway-ul;
- problema canonică;
- prioritatea;
- statusul;
- intervalul calendaristic.
Perimetrul se aplică pe partea de server și nu este doar un filtru al interfeței.
Acest lucru este important pentru:
- securitate;
- separarea responsabilităților;
- corectitudinea indicatorilor-cheie de performanță (KPI);
- gestionarea regiunilor;
- scalare;
- prevenirea scurgerilor de date între departamente.
Subiecte conexe
A fost utilă această pagină?
Vă mulțumim pentru răspuns!