Gestionarea incidentelor masive
Gestionarea incidentelor care afectează multe active – corelarea automată, ciclul de viață al incidentului, tabloul de bord operațional și analiza post-incident.
Un incident masiv (Massive Incident) este un ansamblu de probleme operaționale (Operational Issues) legate între ele, care au o cauză comună.
Astfel, evenimentele operaționale de amploare pot fi analizate ca o singură entitate gestionată.
Corelarea incidentelor
OHM grupează automat problemele operaționale într-un incident masiv atunci când coincid mai mulți factori:
- momentul apariției;
- regiunea;
- cauza fundamentală (Root Cause);
- infrastructura de comunicație;
- versiunea de software;
- un eveniment extern.
Ciclul de viață al incidentului masiv
flowchart TD
    A["Detectare"] --> B["Corelare"]
    B --> C["Incident masiv creat"]
    C --> D["Investigare"]
    D --> E["Atenuare"]
    E --> F["Restabilire"]
    F --> G["Verificare"]
    G --> H["Analiză post-incident"]
    H --> I["Închidere"]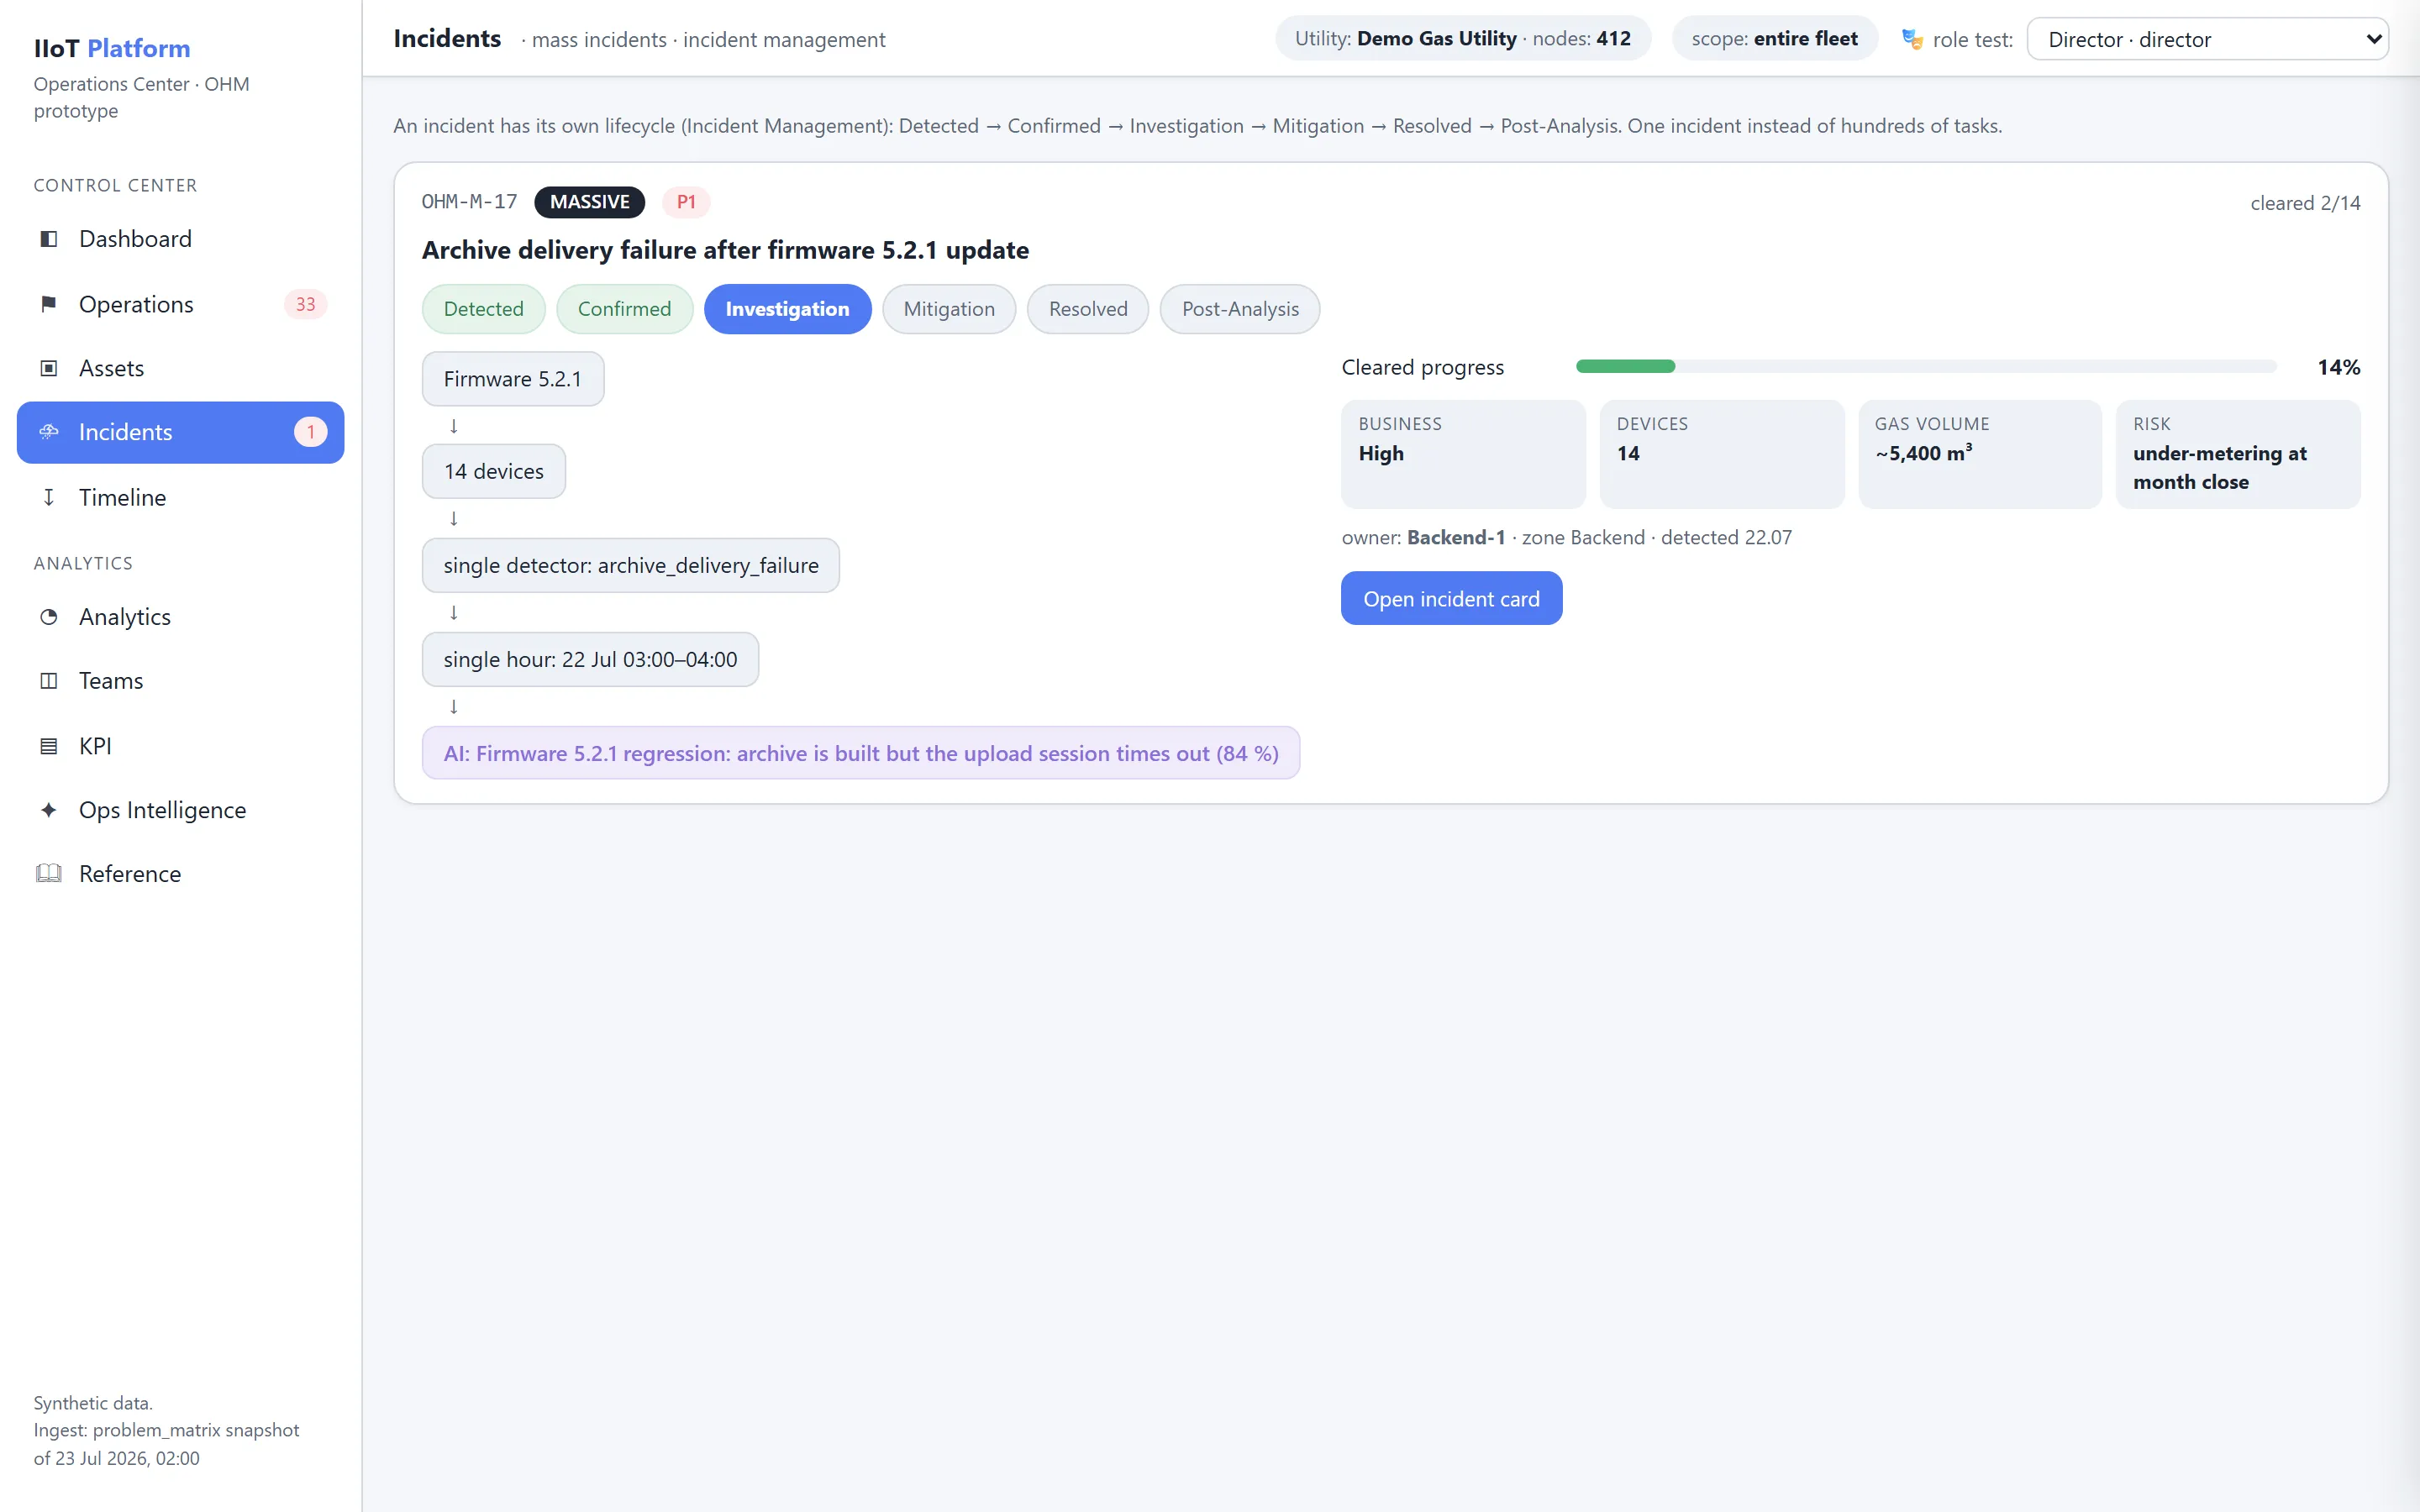
Tabloul de bord operațional
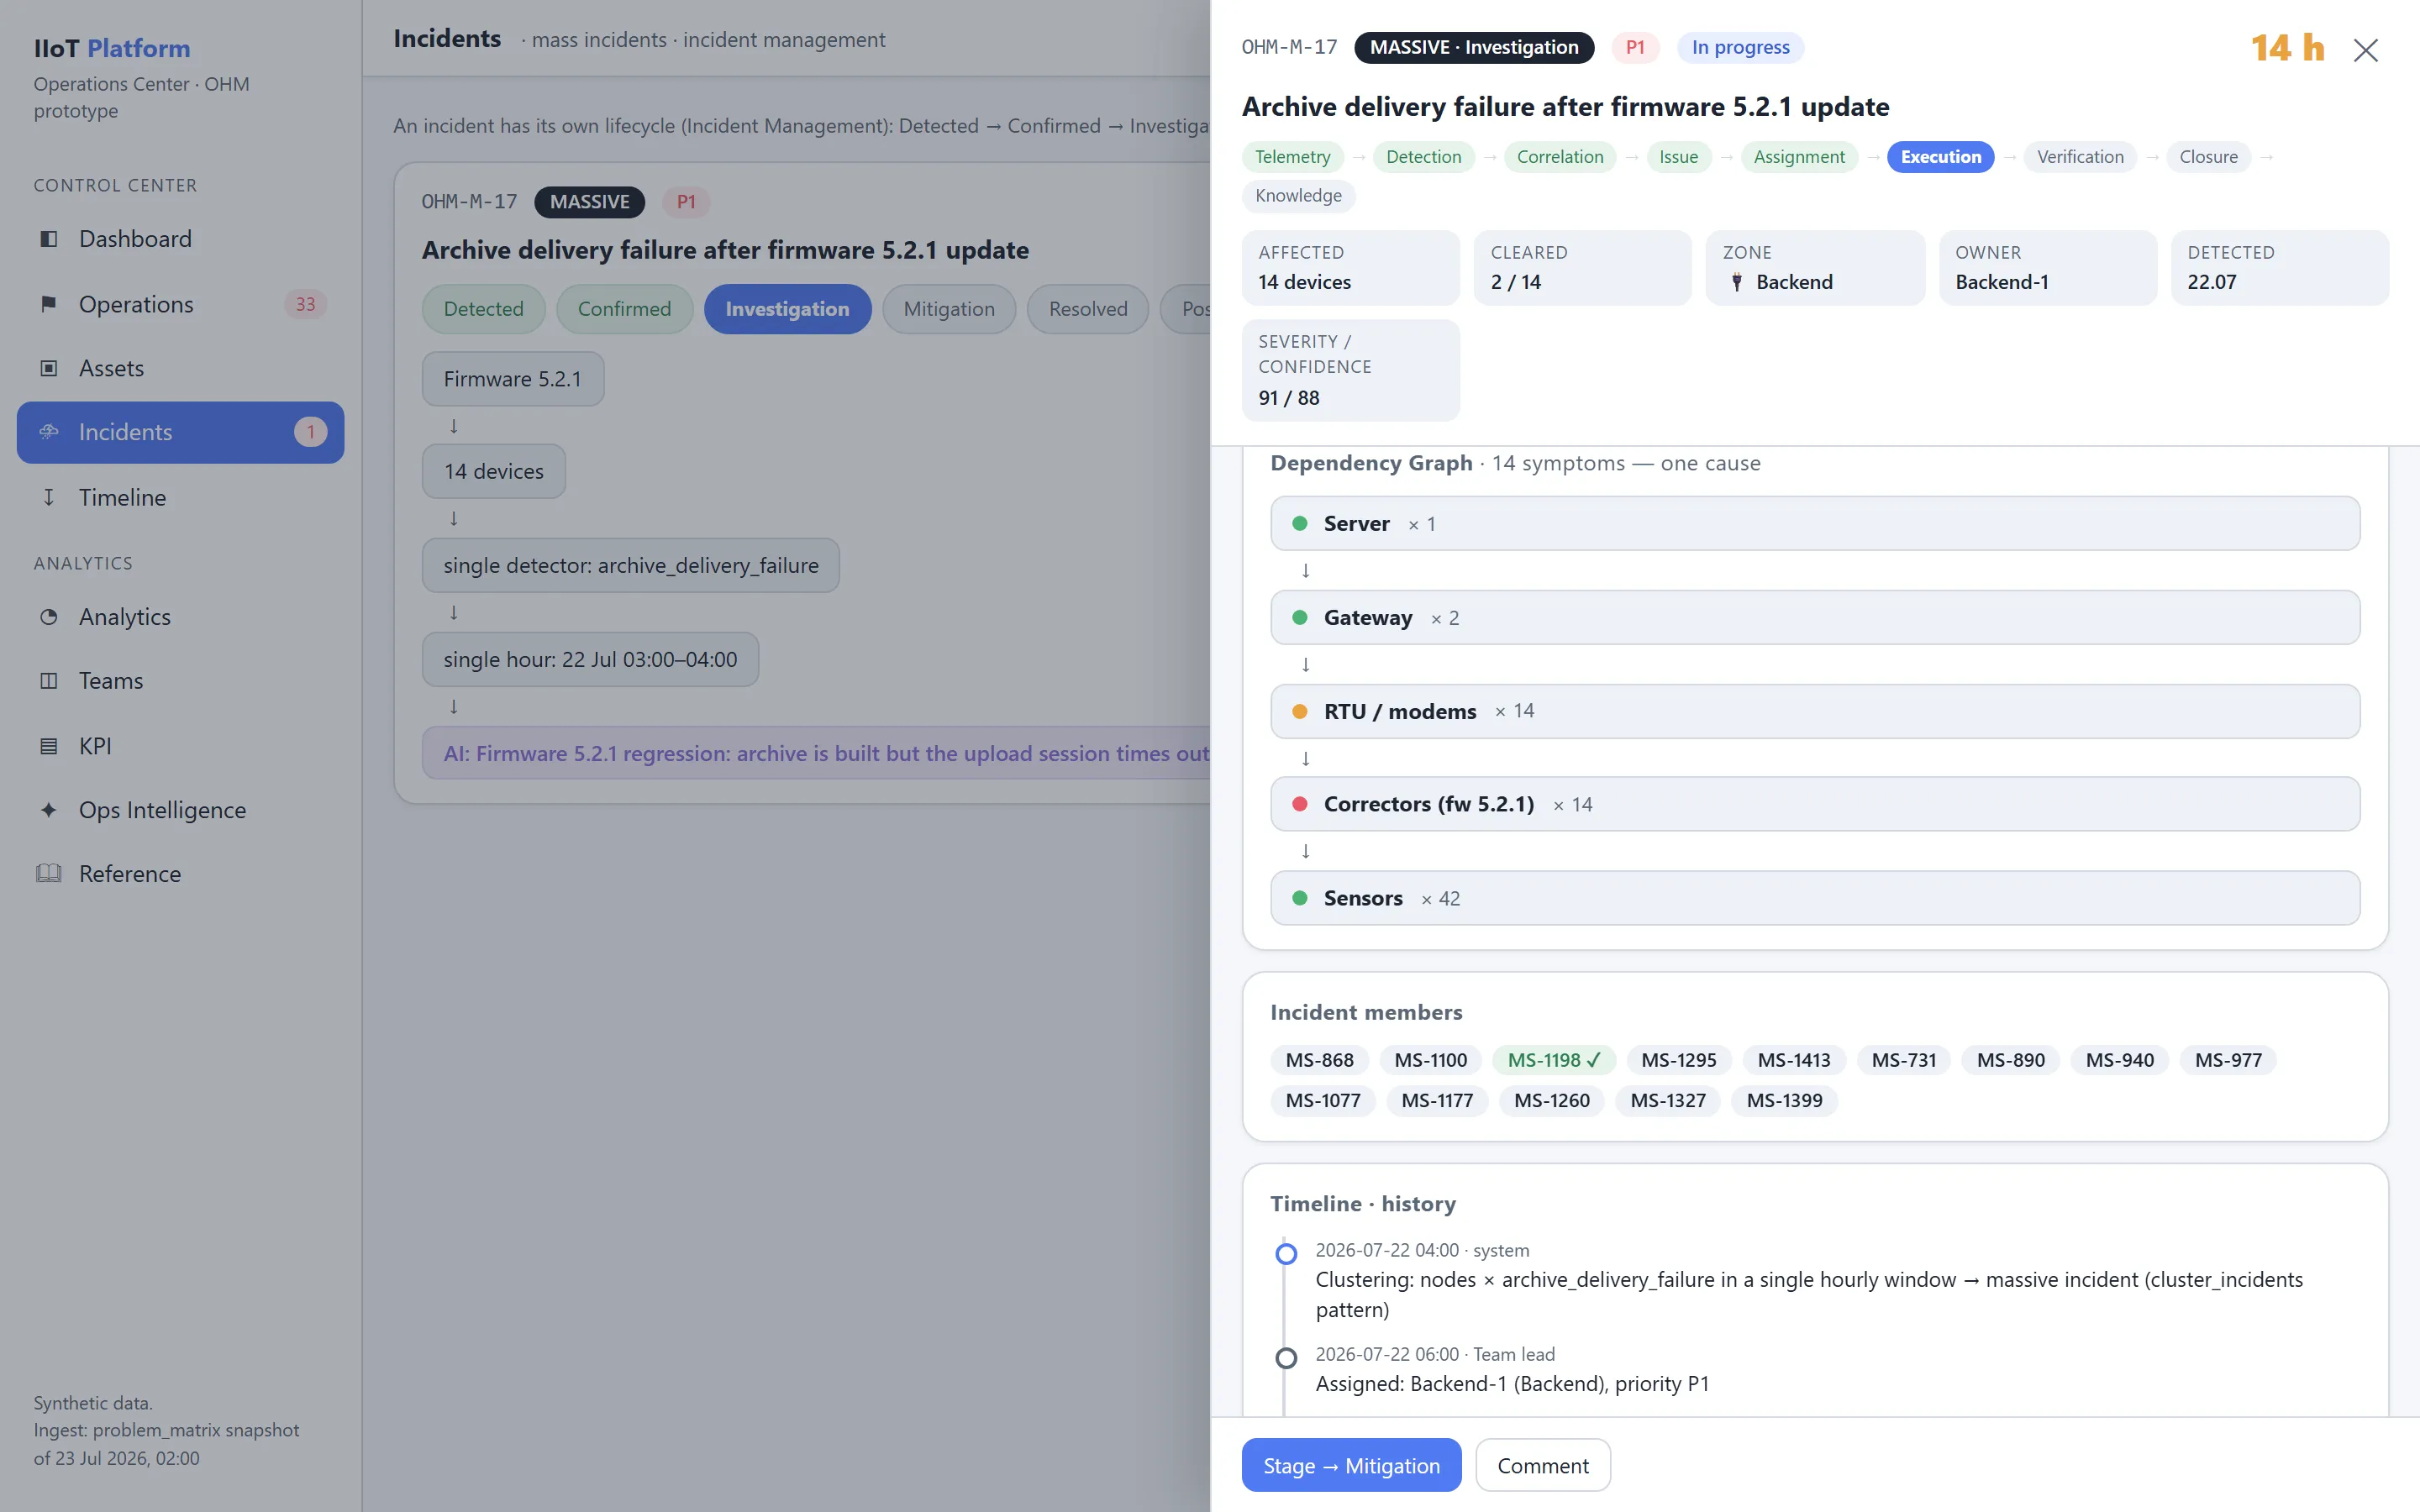
Pentru fiecare incident masiv, sistemul afișează:
- numărul de probleme operaționale asociate;
- numărul de active;
- regiunile afectate;
- cauza fundamentală presupusă;
- statusul investigării;
- acordul privind nivelul serviciilor (SLA);
- impactul asupra activității (Business Impact);
- progresul curent al restabilirii.
Analiza post-incident
După închidere, incidentul este supus unei analize.
Raportul cuprinde:
- cronologia;
- cauza fundamentală confirmată;
- eficacitatea reacției;
- respectarea termenelor SLA;
- lecțiile învățate;
- recomandările pentru a preveni reapariția.
Toate concluziile pot fi transformate automat în articole din baza de cunoștințe (Knowledge Base).
Subiecte conexe
A fost utilă această pagină?
Vă mulțumim pentru răspuns!