Upravljanje masovnim incidentima
Upravljanje incidentima koji zahvaćaju velik broj objekata – automatska korelacija, životni ciklus incidenta, operativna nadzorna ploča i analiza nakon incidenta.
Masovni incident (Massive Incident) skup je međusobno povezanih operativnih problema (Operational Issues) koji imaju zajednički uzrok.
To omogućuje da se operativni događaji velikih razmjera analiziraju kao jedinstven entitet kojim se upravlja.
Korelacija incidenata
OHM automatski grupira operativne probleme u masovni incident kada se podudara više faktora:
- vrijeme nastanka;
- regija;
- temeljni uzrok (Root Cause);
- komunikacijska infrastruktura;
- verzija softvera;
- vanjski događaj.
Životni ciklus masovnog incidenta
flowchart TD
    A["Otkrivanje"] --> B["Korelacija"]
    B --> C["Stvoren masovni incident"]
    C --> D["Ispitivanje uzroka"]
    D --> E["Ublažavanje posljedica"]
    E --> F["Oporavak"]
    F --> G["Verifikacija"]
    G --> H["Analiza nakon incidenta"]
    H --> I["Zatvaranje"]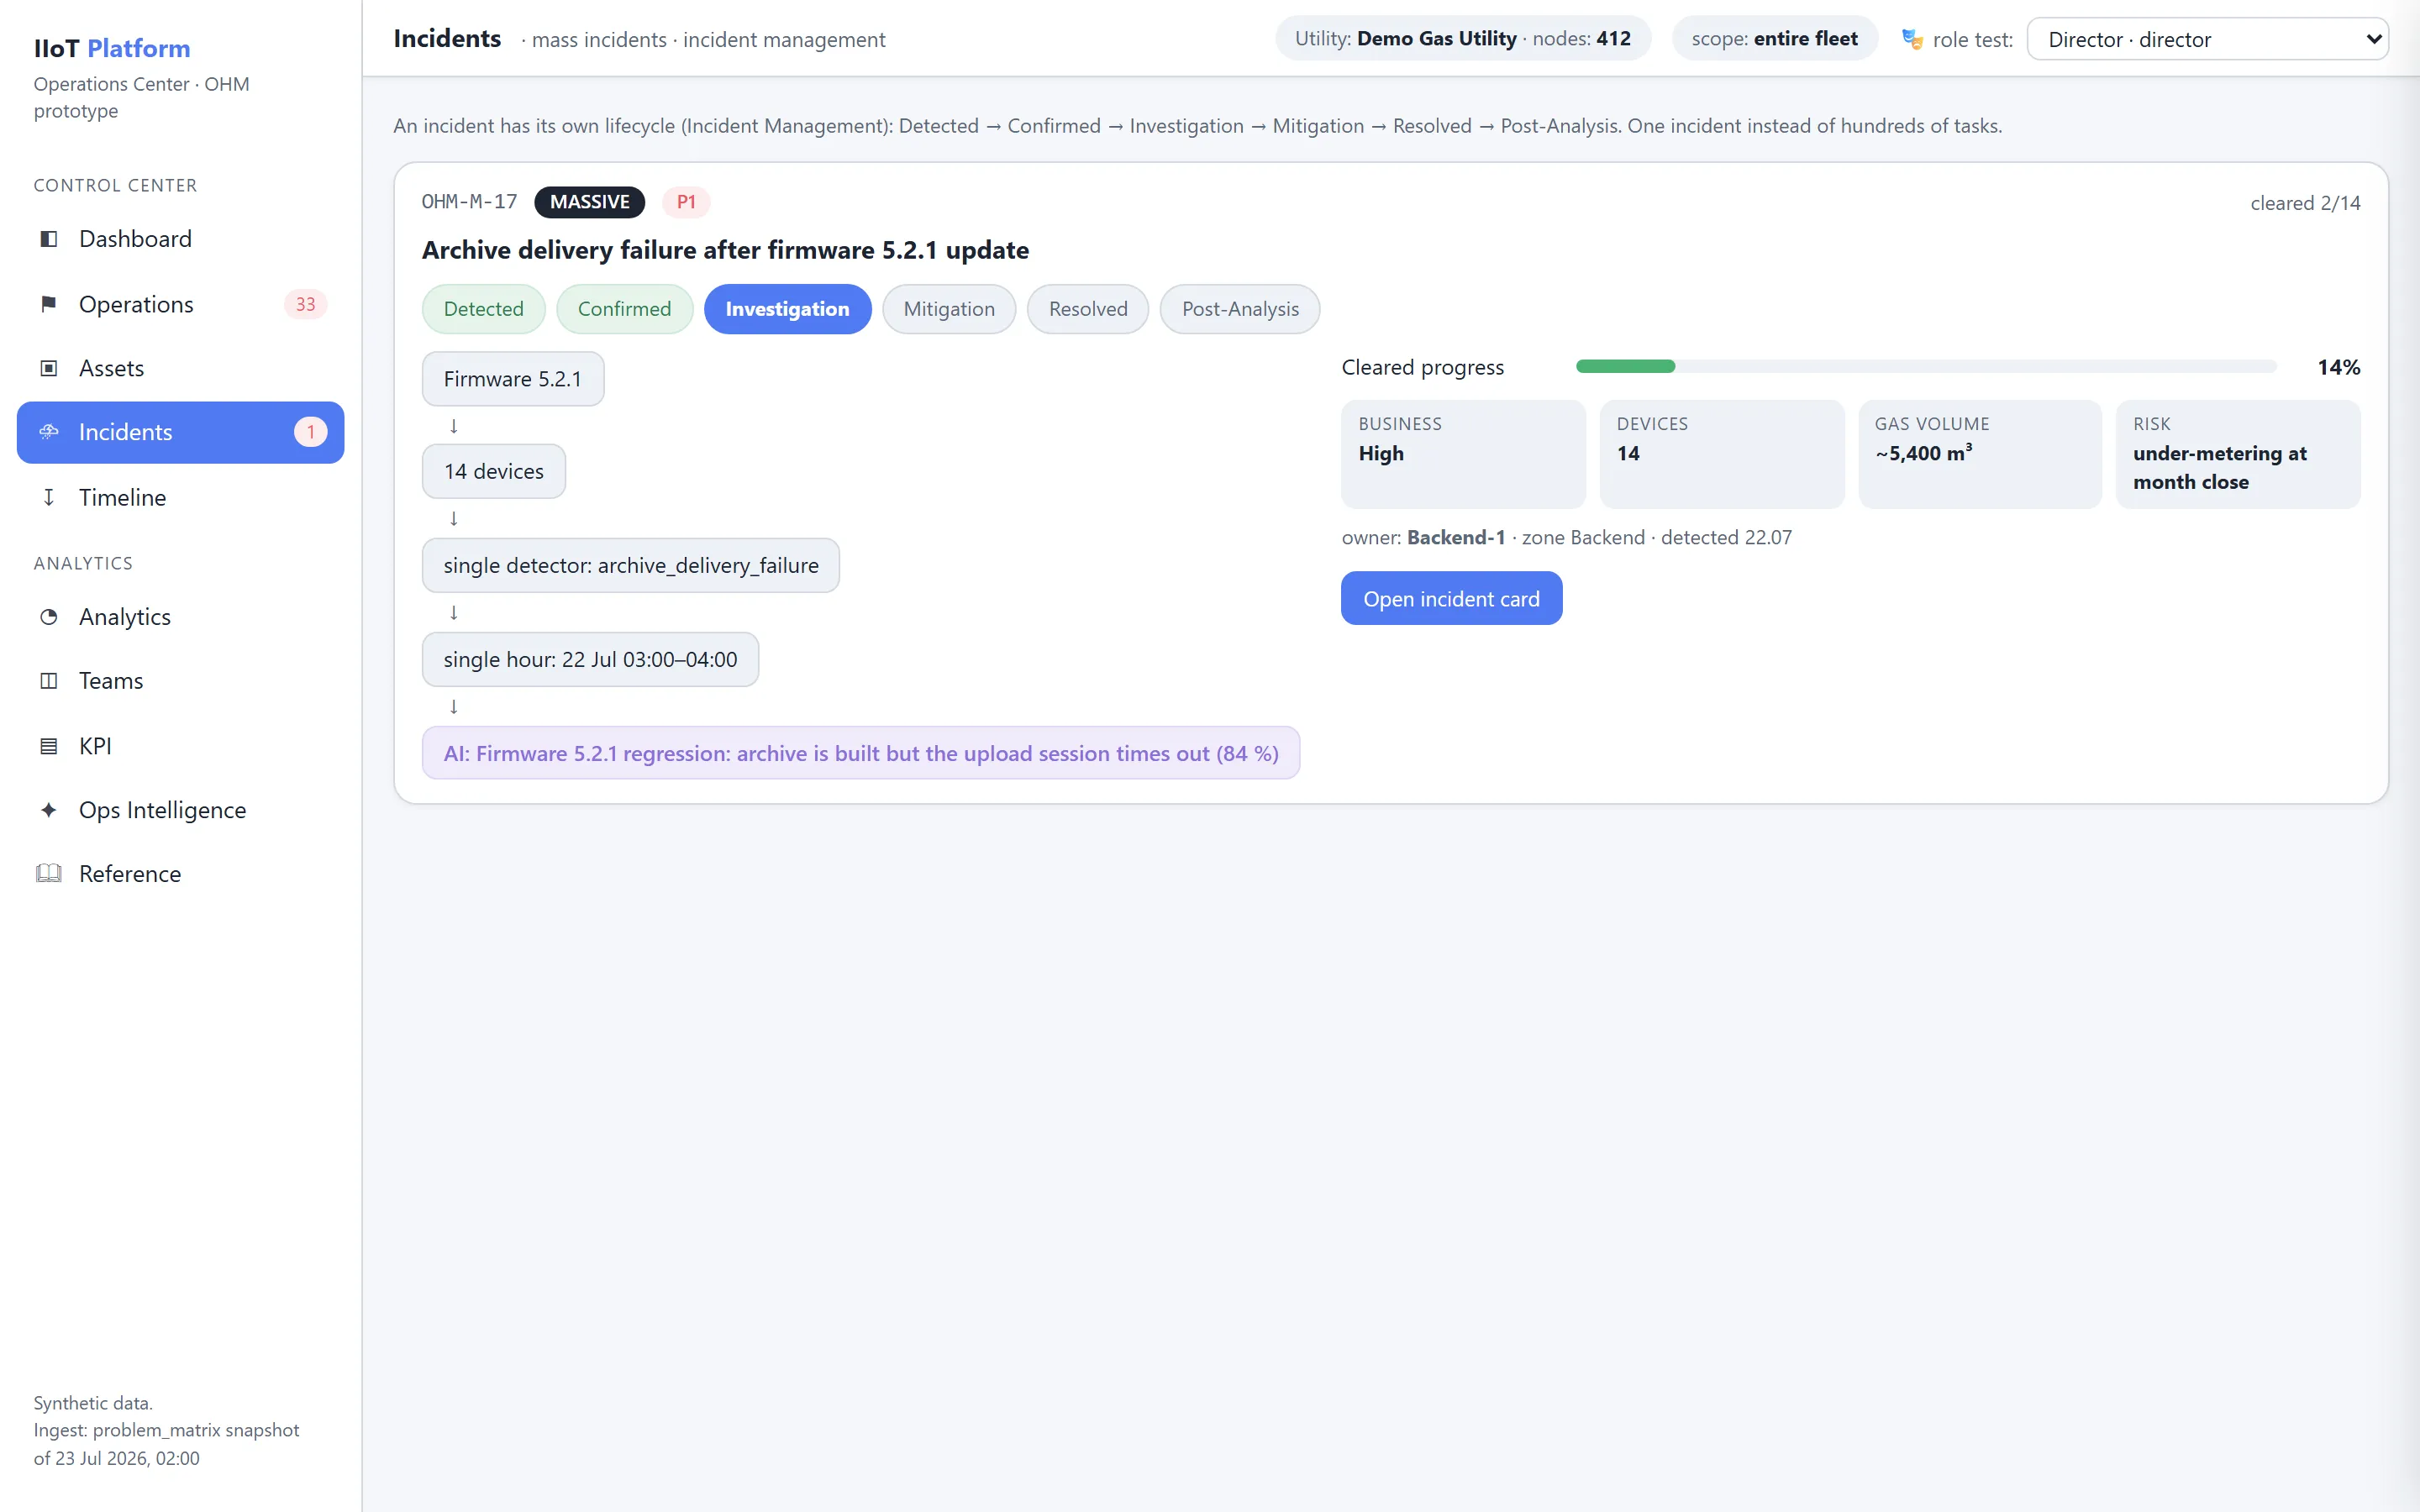
Operativna nadzorna ploča
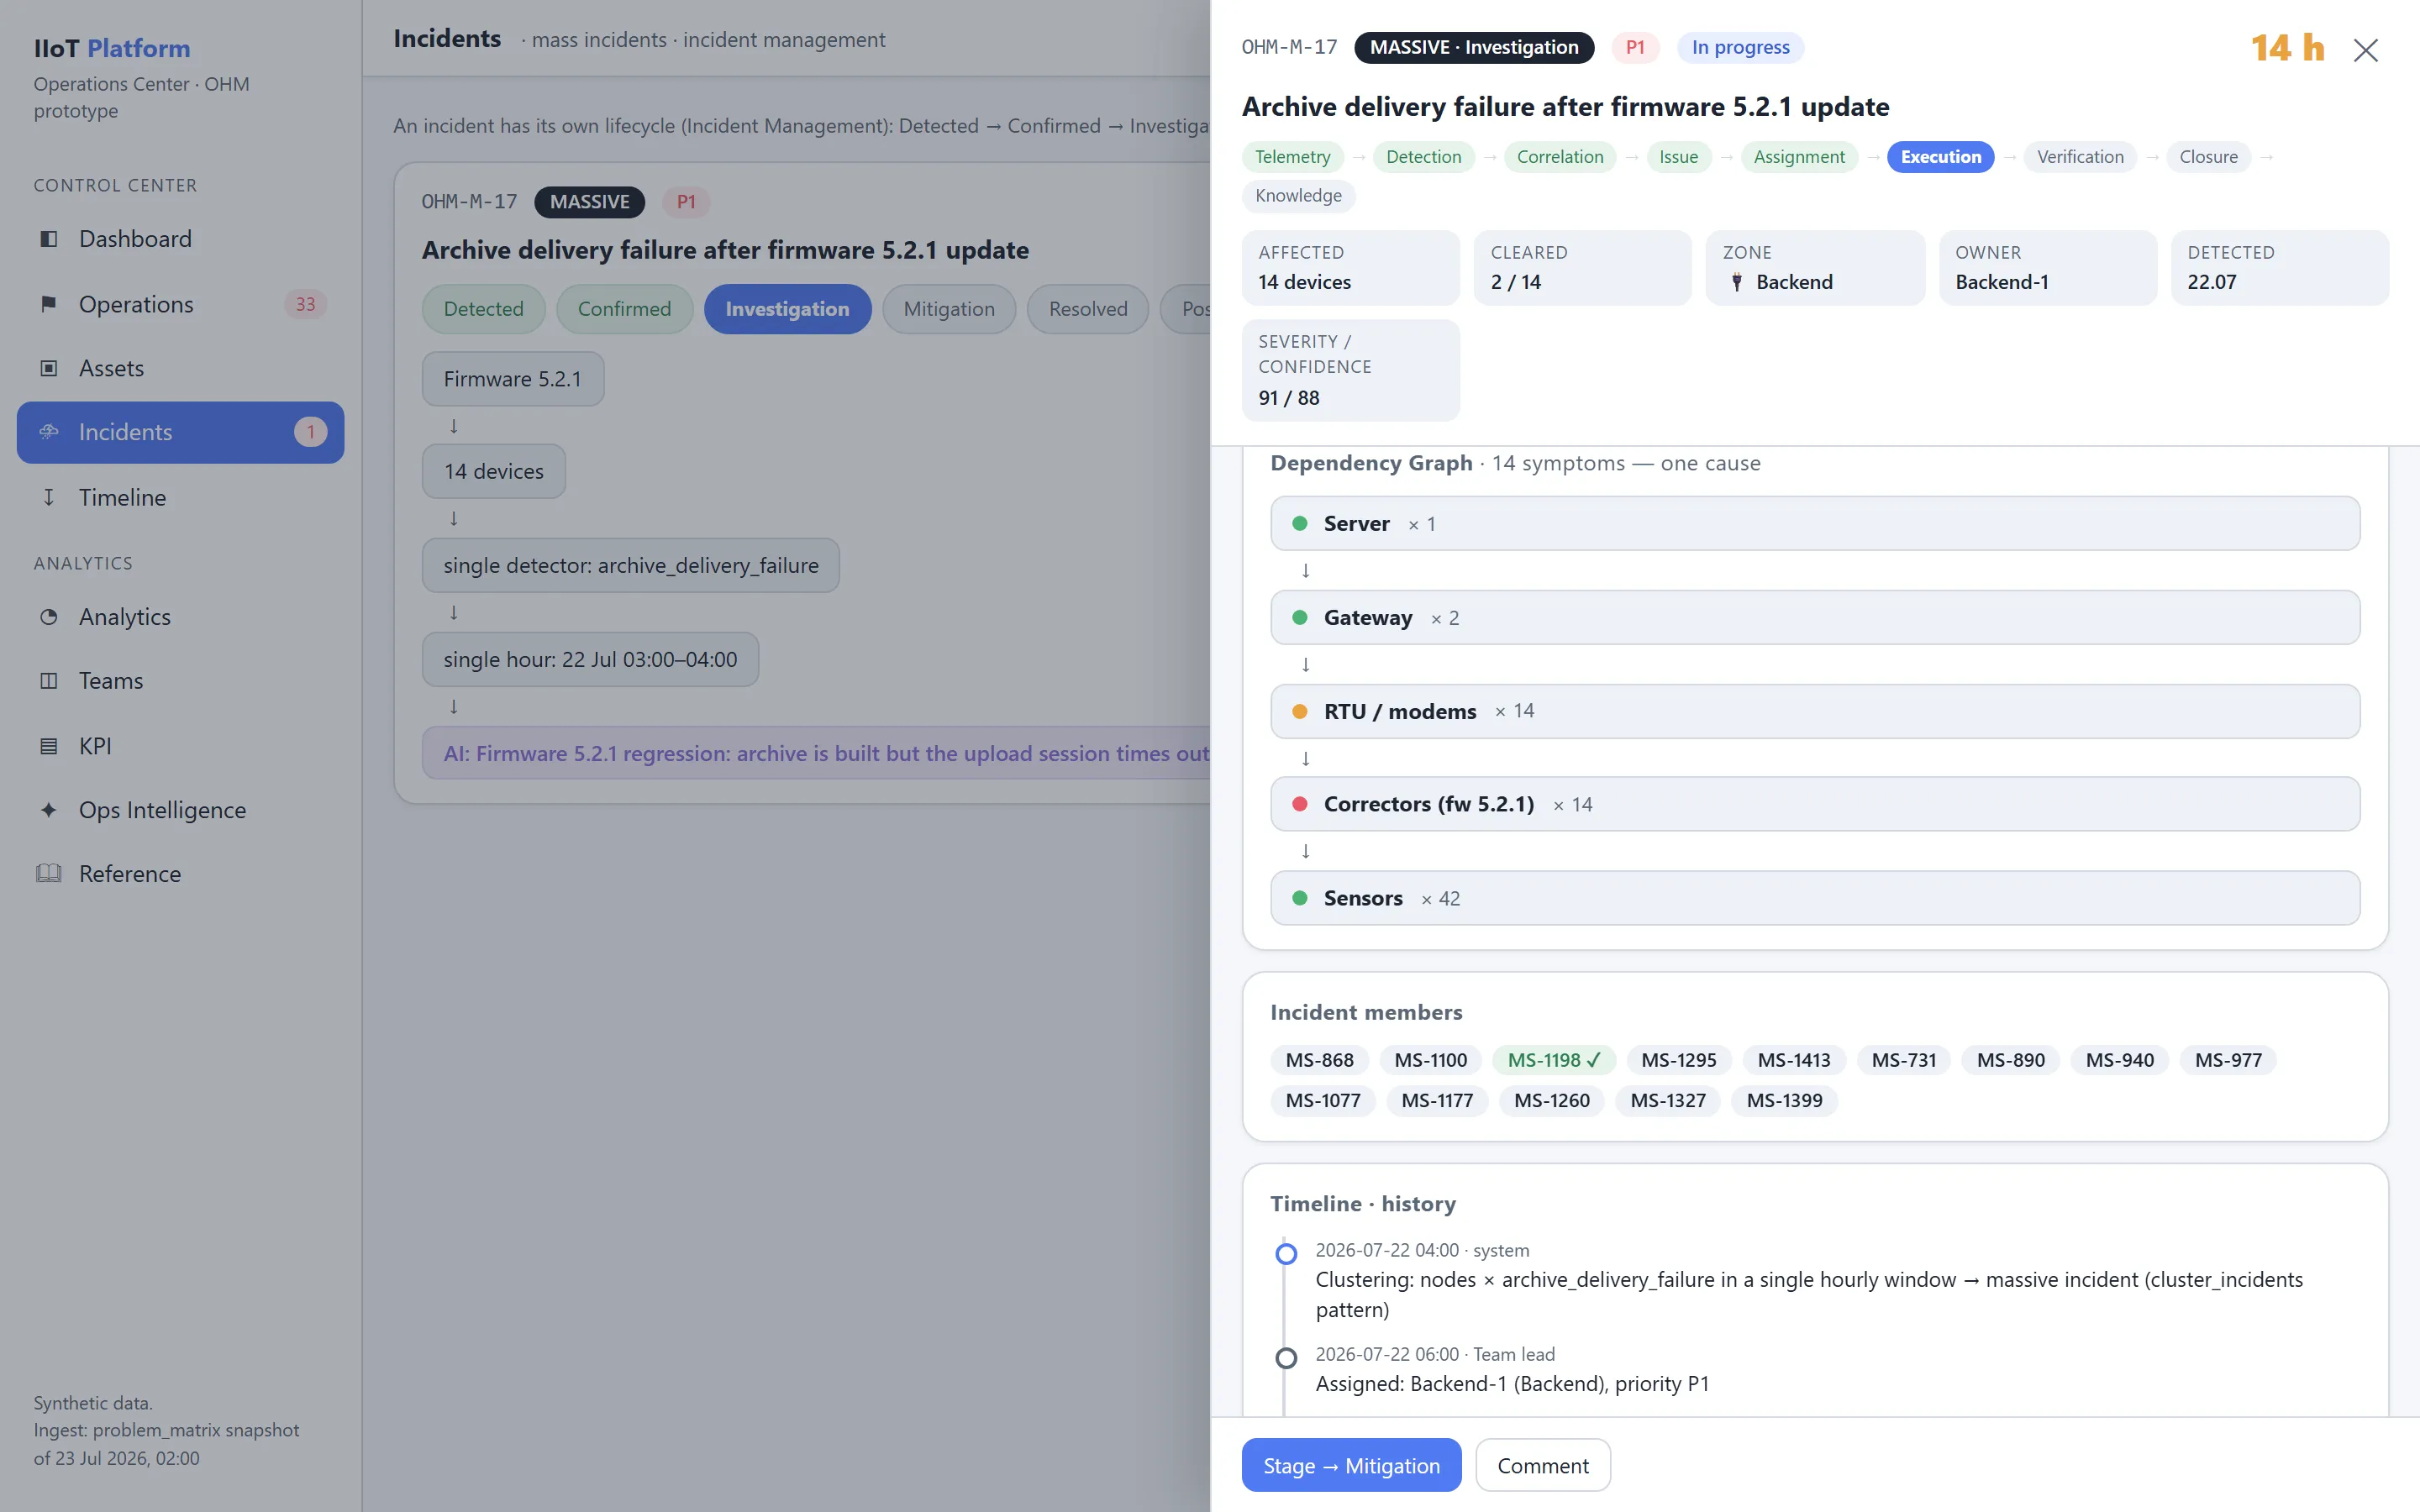
Za svaki masovni incident sustav prikazuje:
- broj povezanih operativnih problema;
- broj objekata (Assets);
- pogođene regije;
- pretpostavljeni temeljni uzrok;
- status ispitivanja;
- sporazum o razini usluge (SLA);
- utjecaj na poslovanje (Business Impact);
- trenutačni napredak oporavka.
Analiza nakon incidenta
Nakon zatvaranja incident se analizira.
Izvješće obuhvaća:
- kronologiju (Timeline);
- potvrđeni temeljni uzrok;
- učinkovitost reagiranja;
- poštivanje SLA rokova;
- stečena iskustva;
- preporuke za sprječavanje ponavljanja.
Svi se zaključci mogu automatski pretvoriti u članke baze znanja (Knowledge Base).
Povezane teme
Je li vam ova stranica bila korisna?
Hvala vam na povratnoj informaciji!